

Go: с нуля до своего блога Урок 40 из 50
Загрузка изображений: чужой файл на вашем диске
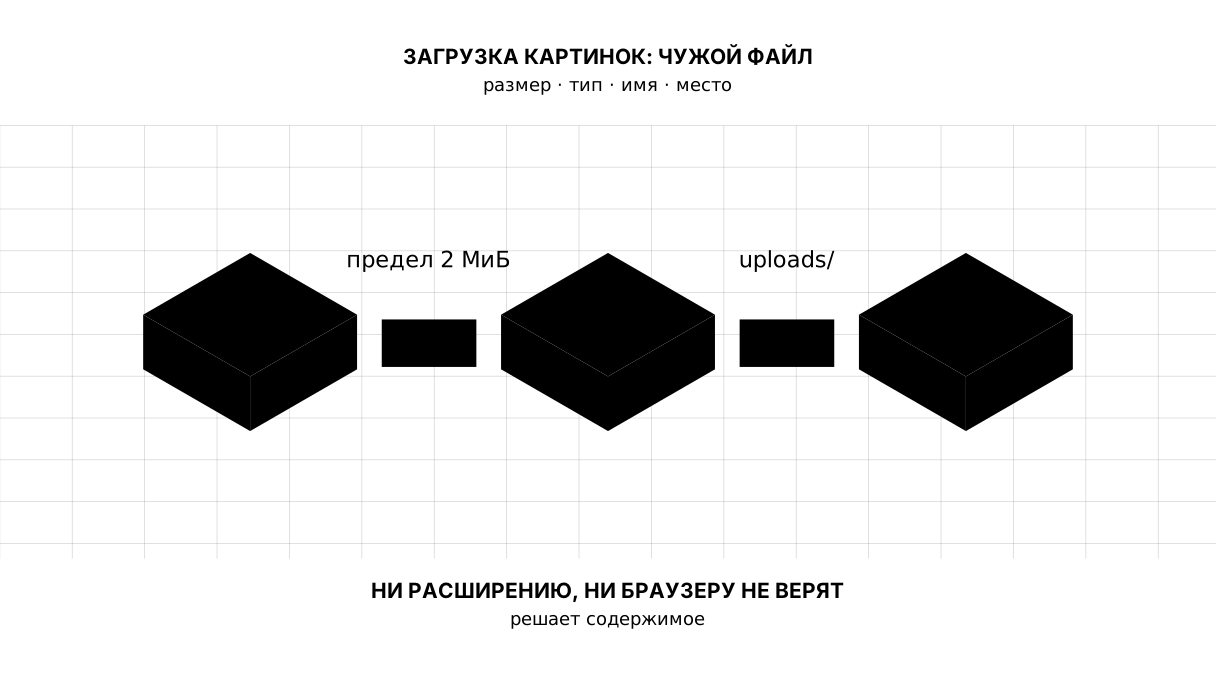
Сороковой урок курса по Go. Форма, в которой едет файл, и четыре вещи, которые проверяют до того, как он ляжет на диск: размер, тип по содержимому, собственное имя вместо присланного и место, куда его класть. Заодно приводим /static в порядок: brand, css, images, js, uploads.
Зачем это нужно
Статья без картинки — половина статьи. Добавить загрузку несложно, и именно поэтому её чаще всего делают неправильно.
Файл, который присылает читатель, — это чужие байты с чужим именем, чужим расширением и чужим заявленным типом. Ни одному из этих трёх слов верить нельзя, и каждому соответствует своя дыра: имя уводит файл из вашей папки, расширение прячет скрипт под видом картинки, а размер занимает диск и память.
Сегодня закроем все три — и сразу увидим, что проверка типа состоит не из одного шага, а из двух: первые байты говорят «похоже на картинку», а не «это картинка». Заодно разложим /static так, как раскладывают в настоящих проектах.
Сразу целиком
Новая папка, go mod init sabaq37:
package main

import (
	"bytes"
	"crypto/rand"
	"encoding/base64"
	"encoding/binary"
	"fmt"
	"hash/crc32"
	"image"
	_ "image/gif"
	_ "image/jpeg"
	"image/png"
	"io"
	"mime/multipart"
	"net/http"
	"net/http/httptest"
	"os"
	"path/filepath"
	"strings"
)

// maxUpload — сколько байт мы вообще готовы прочитать. Без этого числа любой
// желающий занимает память сервера одним запросом.
const maxUpload = 1 << 20 // 1 МиБ

// allowed — типы, которые мы принимаем. Тип определяем по содержимому,
// а не по расширению и не по тому, что сказал браузер.
var allowed = map[string]string{
	"image/png":  ".png",
	"image/jpeg": ".jpg",
	"image/gif":  ".gif",
}

// maxSide — предел на сторону картинки. Файл в несколько десятков байт может
// заявить двадцать тысяч пикселей, и на распаковку уйдут гигабайты памяти.
// Заголовок читать дёшево, пиксели — нет, поэтому размер проверяют до
// распаковки.
const maxSide = 8000

func main() {
	dir, _ := os.MkdirTemp("", "uploads")
	defer os.RemoveAll(dir)

	srv := httptest.NewServer(http.MaxBytesHandler(routes(dir), maxUpload))
	defer srv.Close()

	fmt.Println("== имя файла из формы")
	for _, name := range []string{"сурет.png", "../../../etc/passwd", "a/b/c.png", ""} {
		fmt.Printf("%-22q -> %q\n", name, filepath.Base(name))
	}

	fmt.Println()
	fmt.Println("== что принимает сервер")
	fmt.Println("настоящий png:      ", send(srv.URL, "photo.png", smallPNG()))
	fmt.Println("html под видом png: ", send(srv.URL, "photo.png", []byte("<html><script>alert(1)</script>")))
	fmt.Println("имя с путём:        ", send(srv.URL, "../../evil.png", smallPNG()))
	fmt.Println("png-бомба:          ", send(srv.URL, "bomb.png", bomb()))
	fmt.Println("слишком большой:    ", send(srv.URL, "big.png", bytes.Repeat(smallPNG(), 200000)))

	fmt.Println()
	fmt.Println("== что осталось в папке")
	entries, _ := os.ReadDir(dir)
	for _, e := range entries {
		fmt.Println(" ", e.Name())
	}
}

func routes(dir string) http.Handler {
	mux := http.NewServeMux()

	mux.HandleFunc("POST /upload", func(w http.ResponseWriter, r *http.Request) {
		// 32 КиБ держим в памяти, остальное само уедет во временный файл.
		if err := r.ParseMultipartForm(32 << 10); err != nil {
			http.Error(w, "файл слишком большой", http.StatusRequestEntityTooLarge)
			return
		}
		file, header, err := r.FormFile("image")
		if err != nil {
			http.Error(w, "файла нет", http.StatusBadRequest)
			return
		}
		defer file.Close()

		// Первые 512 байт решают, что это на самом деле. Ни расширение, ни
		// Content-Type от браузера доверия не заслуживают.
		head := make([]byte, 512)
		n, _ := io.ReadFull(file, head)
		kind := strings.SplitN(http.DetectContentType(head[:n]), ";", 2)[0]
		ext, ok := allowed[kind]
		if !ok {
			http.Error(w, "это не картинка: "+kind, http.StatusUnsupportedMediaType)
			return
		}
		if _, err := file.Seek(0, io.SeekStart); err != nil {
			http.Error(w, "не вышло", http.StatusInternalServerError)
			return
		}

		// Первые байты — подсказка, а не доказательство: их нетрудно приписать,
		// дописав начало настоящей картинки к любому файлу. Поэтому разбираем
		// заголовок самой картинки — он либо читается, либо нет — и проверяем
		// размеры, которые он объявляет.
		cfg, _, err := image.DecodeConfig(file)
		if err != nil {
			http.Error(w, "это не картинка: "+err.Error(), http.StatusUnsupportedMediaType)
			return
		}
		if cfg.Width > maxSide || cfg.Height > maxSide {
			http.Error(w, fmt.Sprintf("картинка слишком большая: %dx%d", cfg.Width, cfg.Height), http.StatusRequestEntityTooLarge)
			return
		}
		if _, err := file.Seek(0, io.SeekStart); err != nil {
			http.Error(w, "не вышло", http.StatusInternalServerError)
			return
		}

		// Имя придумываем сами. То, что прислали, годится только для показа
		// человеку — и то после экранирования.
		name := random() + ext
		path := filepath.Join(dir, name)
		dst, err := os.Create(path)
		if err != nil {
			http.Error(w, "не вышло", http.StatusInternalServerError)
			return
		}
		defer dst.Close()
		if _, err := io.Copy(dst, file); err != nil {
			// Половина файла на диске хуже, чем ничего.
			os.Remove(path)
			http.Error(w, "не вышло", http.StatusInternalServerError)
			return
		}

		fmt.Fprintf(w, "сохранили как %s (прислали %q)", name, filepath.Base(header.Filename))
	})

	return mux
}

func random() string {
	raw := make([]byte, 12)
	rand.Read(raw)
	return base64.RawURLEncoding.EncodeToString(raw)
}

// smallPNG — настоящая картинка размером один пиксель.
func smallPNG() []byte {
	var buf bytes.Buffer
	png.Encode(&buf, image.NewRGBA(image.Rect(0, 0, 1, 1)))
	return buf.Bytes()
}

// bomb — по первым байтам честный PNG, который заявляет двадцать тысяч
// пикселей в стороне, а весит семьдесят четыре байта.
func bomb() []byte {
	raw := smallPNG()
	binary.BigEndian.PutUint32(raw[16:20], 20000) // ширина в заголовке IHDR
	binary.BigEndian.PutUint32(raw[20:24], 20000) // высота
	binary.BigEndian.PutUint32(raw[29:33], crc32.ChecksumIEEE(raw[12:29]))
	return raw
}

func send(base, name string, body []byte) string {
	var buf bytes.Buffer
	form := multipart.NewWriter(&buf)
	part, err := form.CreateFormFile("image", name)
	if err != nil {
		return "ошибка: " + err.Error()
	}
	part.Write(body)
	form.Close()

	resp, err := http.Post(base+"/upload", form.FormDataContentType(), &buf)
	if err != nil {
		return "ошибка: " + err.Error()
	}
	defer resp.Body.Close()
	out, _ := io.ReadAll(resp.Body)
	return fmt.Sprintf("%d — %s", resp.StatusCode, strings.TrimSpace(string(out)))
}
Вывод:
== имя файла из формы
"сурет.png"            -> "сурет.png"
"../../../etc/passwd"  -> "passwd"
"a/b/c.png"            -> "c.png"
""                     -> "."

== что принимает сервер
настоящий png:       200 — сохранили как pM361aTkUKWtjqjC.png (прислали "photo.png")
html под видом png:  415 — это не картинка: text/html
имя с путём:         200 — сохранили как s035PI2jgJrUCVyT.png (прислали "evil.png")
png-бомба:           413 — картинка слишком большая: 20000x20000
слишком большой:     413 — файл слишком большой

== что осталось в папке
  pM361aTkUKWtjqjC.png
  s035PI2jgJrUCVyT.png
Разбор
multipart/form-data: форма, в которой едет файл
Обычная форма отправляет пары «имя — значение» одной строкой. Файл так не отправишь, поэтому у формы с файлом другой вид:
<form method="post" action="/upload" enctype="multipart/form-data">
  <input type="file" name="image" accept="image/*">
  <button>загрузить</button>
</form>
enctype здесь обязателен. Забудете — браузер отправит только имя файла, без содержимого, и FormFile вернёт ошибку, которую потом долго ищут.
В Go такую форму разбирает ParseMultipartForm, а r.FormFile("image") отдаёт три вещи: сам файл, заголовок с присланным именем и размером, и ошибку.
Предел ставят до чтения, а не после
http.MaxBytesHandler оборачивает сервер и обрывает чтение на заданном числе байт. В выводе видно, чем это кончается для слишком большого файла: 413.
Ставить предел после чтения бессмысленно: чтобы узнать размер, файл придётся сначала прочитать, а значит, уже занять им память или диск. Проверка header.Size — это проверка того, что сказал браузер, и она ничего не гарантирует.
ParseMultipartForm(32 << 10) — второе число, и оно про другое: сколько держать в памяти. Всё, что больше, Go сам положит во временный файл и уберёт за собой.
Образ. Турникет на входе, а не охранник в конце коридора. Турникет не пускает того, кто не проходит по размеру; охранник в конце обнаружит его, когда тот уже внутри.
Имя файла придумываете вы
Первая часть вывода — про имя. filepath.Base отрезает от ../../../etc/passwd всё, кроме passwd, и это уже неплохо. Но полагаться на него одного не стоит: посмотрите на последнюю строку — из пустого имени получается ., и такой файл вы создадите молча.
Поэтому имя не чистят, а придумывают: двенадцать случайных байт плюс расширение, которое мы сами и выбрали. Присланное имя годится только на то, чтобы показать его человеку — и то после экранирования, как в уроке про XSS.
Так решается сразу несколько бед: файл не может уйти из папки, не может затереть чужой, не может оказаться .htaccess или index.html, и в имени не окажется ни пробелов, ни кириллицы, ни точек с запятой.
Тип определяют по содержимому
Вторая строка вывода — главная. Файл с именем photo.png, внутри которого лежит <html><script>, отвергнут с 415, потому что мы спросили не имя, а содержимое:
head := make([]byte, 512)
n, _ := io.ReadFull(file, head)
kind := strings.SplitN(http.DetectContentType(head[:n]), ";", 2)[0]
http.DetectContentType смотрит на первые байты и отвечает по тому, что там на самом деле: у PNG это \x89PNG, у JPEG — \xFF\xD8\xFF. Пятьсот двенадцать байт — не наша выдумка, а размер, на который рассчитан алгоритм.
Расширению верить нельзя: его пишет тот, кто присылает. Заголовку Content-Type из формы — тоже: его пишет браузер, а браузер можно не использовать вовсе.
И белый список вместо чёрного: мы перечисляем, что принимаем, а не что запрещаем. Это то же правило, что и с сортировкой в уроке про инъекции, и оно работает по той же причине — фантазия чужого человека богаче вашей.
После проверки не забудьте file.Seek(0, io.SeekStart): пятьсот двенадцать байт уже прочитаны, и без перемотки файл сохранится обрезанным.
Первые байты — подсказка, а не доказательство
DetectContentType смотрит на сигнатуру, а сигнатуру можно приписать: возьмите начало настоящего png, допишите к нему что угодно — и проверка пройдена. Поэтому за ней идёт вторая, честная: стандартная библиотека разбирает заголовок самой картинки.
cfg, _, err := image.DecodeConfig(file)
image.DecodeConfig читает только заголовок — ширину, высоту и модель цвета — и не трогает пиксели. Он либо разберёт файл, либо вернёт ошибку, и здесь уже не отделаешься подделанным началом: у png сходится контрольная сумма, у jpeg — структура сегментов.
Заодно он отвечает на вопрос, который размер файла не закрывает. В выводе есть строка png-бомба: 413. Файл весит семьдесят четыре байта и по всем признакам настоящий, но в заголовке у него написано 20000x20000. Распаковать такую картинку — значит попросить у системы гигабайты памяти на один запрос. Поэтому объявленный размер проверяют до распаковки:
if cfg.Width > maxSide || cfg.Height > maxSide {
Отсюда же понятно, почему в списке нет webp: в стандартной библиотеке нет декодера для него, а принимать формат, который мы не умеем проверить, — значит снова поверить на слово.
И после проверки файл снова перематывают в начало: заголовок прочитан, а на диск должен лечь весь файл.
Дерево /static: brand, css, images, js, uploads
С этого шага блог раскладывает файлы по папкам, и дальше так и будет. Пока их было три, они спокойно лежали рядом — заводить папки ради трёх файлов значит наводить порядок там, где беспорядка ещё нет. Сегодня появляется четвёртый вид файлов, чужой, и с ним правило меняется.
Меняется оно один раз и на будущее. Дальше в блоге появятся шрифты, иконки, скрипт для поиска, картинки-заглушки, обложки статей — и каждый такой вид займёт свою папку, а не ляжет в общую кучу. Раскладывать сорок файлов задним числом дороже, чем завести пять папок сейчас:
static/
    brand/      логотип и иконки: то, что делает сайт узнаваемым
        logo.svg
    css/
        style.css
    js/
        main.js
    images/     картинки самого сайта: иллюстрации, заглушки
        empty.png
    uploads/    то, что прислали читатели
        2026/09/xxxx.png
Правило простое: своё и чужое лежат в разных папках. brand, css, js, images — наши файлы, они едут вместе с программой. uploads — чужие, они появляются во время работы.
Разделение не про красоту. Своё можно вшить в программу через embed и раздавать с длинным кешем; чужое вшить нельзя — embed работает при сборке, а загруженного тогда ещё нет. И правила безопасности у них разные: свои файлы вы написали сами, чужие — нет.
Внутри uploads полезно разложить по годам и месяцам: тысяча файлов в одной папке — уже неудобно, сто тысяч — уже медленно.
Отдавать чужие файлы осторожно
Раздача загруженного — отдельное место, где ошибаются.
http.FileServer по папке uploads — это нормально, но заголовок X-Content-Type-Options: nosniff из прошлого урока здесь обязателен: без него браузер может решить, что ваш «png» на самом деле HTML, и выполнить его.
Дальше — по обстоятельствам. Большие сайты раздают загруженное с отдельного домена, чтобы даже случайно выполненный скрипт оказался «чужим» для основного сайта и не увидел ни печенья, ни страниц. Для блога это перебор, а вот nosniff и белый список типов — необходимый минимум.
Карта урока
Скажите своими словами
Не подглядывая, ответьте вслух или на бумаге. Ответы — в конце урока.
- Почему предел на размер ставят обёрткой, а не проверкой
header.Size? - Почему имя файла придумывают заново, хотя
filepath.Baseуже отрезал путь? - Почему тип определяют по первым байтам, а не по расширению?
Задание
Обязательное. Добавьте в блог обложку статьи. Форма получает enctype, обработчик — предел, проверку типа по содержимому, разбор заголовка картинки с пределом на сторону и собственное имя. Файлы ложатся в static/uploads, и /static заодно разъезжается по папкам: brand, css, js, images, uploads.
Всё это сделано в step-25 — сверьтесь после того, как напишете сами.
По желанию.
- Отправьте через
curlфайл с именем../../main.goи убедитесь, что он лёг вuploadsпод своим новым именем. - Разложите
uploadsпо годам и месяцам и напишите, что делать со старым содержимым. - Уменьшайте загруженное до разумной ширины перед сохранением. Понадобится пакет
imageиз стандартной библиотеки.
Куда это встанет в блоге
У статьи появляется обложка, а у блога — первая папка, содержимое которой мы не писали. С этого момента /static живёт по правилам: своё отдельно, чужое отдельно.
Долги. Старые файлы не удаляются вместе со статьёй. Картинки не пережимаются: что прислали, то и лежит, вместе с метаданными камеры. И раздаём мы их с того же домена, что и страницы.
Ответы
Показать ответы
- Потому что
header.Size— это то, что сказал браузер, и узнать настоящий размер можно, только прочитав файл, то есть уже потратив на него память или диск. Обёртка обрывает чтение на нужном байте. - Потому что
Baseрешает только задачу с путём. Остаётся пустое имя, превращающееся в., совпадение с чужим файлом, опасные имена вродеindex.htmlи всё, что придумает тот, кто присылает. Своё имя снимает весь этот класс вопросов сразу. - Потому что расширение пишет тот, кто присылает файл, и заявленный
Content-Typeтоже. Первые байты относятся к самому файлу, а не к словам о нём. Но и они только подсказка: настоящий ответ даёт разбор заголовка картинки.
Источники
Если вы нашли ошибку или опечатку в тексте статьи, то сообщите нам об этом
Комментарии (0)
Войдите, чтобы оставить комментарий →
Пока нет комментариев. Будьте первым.