

Go: с нуля до своего блога Урок 7 из 50
Строки и руны в Go: почему казахская буква — два байта
Седьмой урок курса по Go. Почему len("шаңырақ") возвращает 14, а не 7, чем байт отличается от буквы и что такое руна. Обход строки через range, честный подсчёт букв через utf8.RuneCountInString и главная ловушка: обрезка строки по байтам разрубает казахскую букву пополам.
Зачем это нужно
Вам понадобится посчитать длину заголовка, обрезать анонс до ста знаков, проверить, что имя не пустое. По-английски всё это делается очевидным способом — и по-казахски он даёт неверный ответ.
len("шаңырақ") // 14, а букв семь
Это не причуда Go. Так устроено хранение текста в любом языке программирования; Go просто не делает вид, что проблемы нет.
Сразу целиком
Новая папка, go mod init sabaq06, main.go:
package main

import (
	"fmt"
	"unicode/utf8"
)

func main() {
	word := "Go язык"

	fmt.Println("байт:", len(word))
	fmt.Println("букв:", utf8.RuneCountInString(word))

	for i, r := range word {
		fmt.Printf("%d\t%c\n", i, r)
	}

	fmt.Printf("обрезали по пяти байтам: %q\n", word[:5])
}
Прежде чем запускать — не заглядывая ниже, скажите вслух, что она напечатает. Потом запустите и сверьте: расхождение и есть то место, где вы ещё не знаете языка.
go run . печатает:
байт: 11
букв: 7
0	G
1	o
2
3	я
5	з
7	ы
9	к
обрезали по пяти байтам: "Go я"
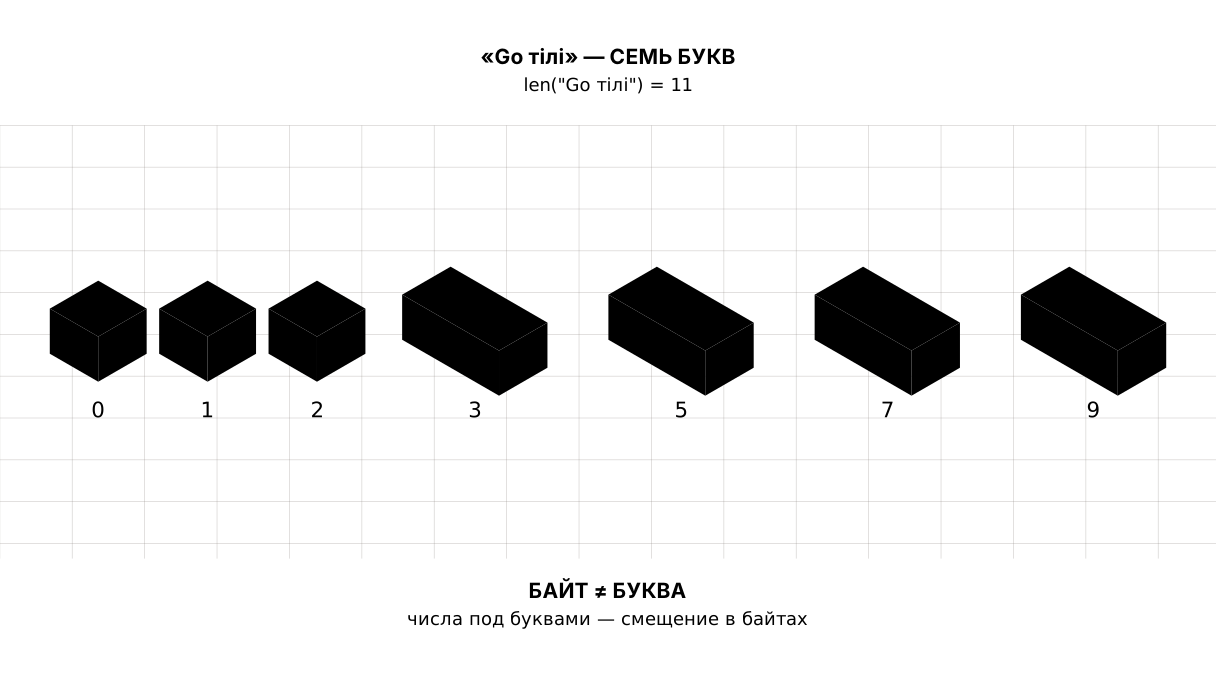
Посмотрите на левый столбец: он идёт 0, 1, 2, 3, 5, 7, 9. Четвёрки и шестёрки нет.
Разбор
Строка — это байты
Строка в Go — последовательность байтов, а не букв. Латинская буква занимает один байт, казахская и русская — два, иероглиф — три, а эмодзи бывает и четыре.
Образ. Лента с наклеенными буквами разной ширины.
lenмеряет ленту в сантиметрах и честно отвечает, сколько их. Просто сантиметр — это не буква, и никогда ею не был.
Так работает UTF-8 — способ записать любой алфавит мира одной кодировкой. Латиница в нём занимает один байт, чтобы старые тексты не потолстели; за это остальные алфавиты платят двумя байтами и больше.
len считает байты — и это правильно
len("Go язык") вернёт 11. Не ошибка: вопрос «сколько занимает» и вопрос «сколько букв» — разные, и len отвечает на первый. Когда вы считаете размер файла или проверяете лимит хранилища, вам нужны именно байты.
Руна — это номер символа
rune — номер символа в общемировом списке Unicode. Тип rune — это int32, то есть просто число.
Образ. Всемирная перепись букв. У «қ» есть свой номер в этом списке, как у дома есть адрес. Руна — не сама буква, а её номер; напечатать её можно, превратив обратно в строку.
Одиночную руну пишут в одинарных кавычках: 'қ' — это руна, "қ" — строка из одной буквы. Разные вещи.
range по строке
for i, r := range word {
range обходит строку по кодовым точкам Unicode, а не по байтам, и на каждом шаге даёт две вещи: i — смещение в байтах от начала, r — саму руну.
Вот почему индексы прыгали: после я на позиции 3 следующая буква оказалась на 5, потому что я заняла два байта. Индекс — это адрес на ленте, а не порядковый номер буквы.
Как посчитать буквы
utf8.RuneCountInString(word) // 7
Пакет unicode/utf8 из стандартной библиотеки, ставить ничего не нужно. Именно это вам нужно, когда вы показываете «осталось 120 символов».
Одна оговорка, чтобы потом не удивляться. Руна — это номер в Unicode, а не гарантированно один видимый знак. Для обычного казахского и русского текста руны и буквы совпадают, и считать можно спокойно. Но é, записанное как e плюс отдельный значок, — это две руны на один видимый символ, а один эмодзи семьи — целых семь. Заметить это можно только там, где такой текст действительно встречается: в именах и в тексте от читателей.
Ловушка: обрезка по байтам
Вот главное, ради чего урок:
word := "шаңырақ"
fmt.Println(word[:5])
Вы просили пять байтов, и Go дал ровно пять. Но пятый байт — это первая половина буквы «ң», и на экране вместо неё будет мусор: шаÒ.
Образ. Разрезать слово ножницами не между буквами, а посередине буквы. Обе половинки существуют, слова больше нет.
Так ломаются анонсы: «обрежем описание до 200 знаков» превращается в обрубленный хвост на каждой второй казахской статье. Правильно — считать буквами:
r := []rune(word)
fmt.Println(string(r[:5]))   // шаңыр
[]rune(word) разбирает строку на руны. Это отдельный проход по всей строке, поэтому в цикле так делать не стоит, — но для одной обрезки нормально.
Что с этим делать на практике
Складывать и сравнивать строки можно спокойно: "Go" + " язык" работает, == сравнивает строки целиком, байт за байтом. Байты вылезают только там, где вы берёте индекс, режете или считаете длину. Правило простое: len — для размера, RuneCountInString — для букв, range — для обхода.
Карта урока
Скажите своими словами
Не подглядывая, ответьте вслух или на бумаге. Ответы — в конце урока.
- Почему при обходе
rangeиндексы шли 0, 1, 2, 3, 5, 7, 9? - Чем
'қ'отличается от"қ"? - Читатель ввёл имя «Әсел» и жалуется, что счётчик показал 8 символов вместо 4. Что произошло?
Задание
Обязательное. Напишите функцию letters(s string) int, которая возвращает число букв в строке, и функцию bytes(s string) int, которая возвращает число байтов. Вызовите обе для "шаңырақ", "Salem" и "Go язык" и напечатайте пары чисел.
По желанию.
- Функция
cut(s string, n int) string, которая обрезает строку доnбукв, не ломая последнюю. Проверьте на"шаңырақ"иn = 5. - Обойдите
"шаңырақ"черезrangeи напечатайте каждую букву с её номером Unicode:fmt.Printf("%c = %d\n", r, r). - Сравните
len("Әсел")иlen("Asel"). Почему разница именно такая?
Куда это встанет в блоге
Оценка времени чтения, обрезка анонса до восьми строк карточки, проверка «заголовок не длиннее шестидесяти знаков» — всё это считает буквы, а не байты. Ошибётесь здесь — и казахская версия каждой статьи будет обрезаться посреди слова, а английская работать как ни в чём не бывало. Такую ошибку не видит тот, кто пишет только на латинице.
Соберите свой блог. Теперь страница блога умеет считать буквы и время чтения. Состояние после этого урока — step-2: заголовок, счёт букв,
readingTimeиif. Ничего, чего вы ещё не проходили, там нет.
Ответы
Показать ответы
- Потому что
i— это смещение в байтах от начала строки, а не порядковый номер буквы.G,oи пробел заняли по одному байту, поэтому шли подряд; каждая казахская буква занимает два, поэтому дальше счёт пошёл через один. 'қ'в одинарных кавычках — руна, то есть число, номер буквы в Unicode."қ"в двойных — строка, то есть последовательность байтов, в данном случае двух. Первое можно сложить с числом, второе — со строкой.- Счётчик считал байты, а не буквы. В «Әсел» четыре буквы, но «Ә», «с», «е» и «л» — кириллица, по два байта каждая, итого восемь. Нужен
utf8.RuneCountInString.
Источники
Если вы нашли ошибку или опечатку в тексте статьи, то сообщите нам об этом
Комментарии (0)
Войдите, чтобы оставить комментарий →
Пока нет комментариев. Будьте первым.