

Go тілі: нөлден өз блогыңызға дейін 7-сабақ (барлығы 50)
Go-дағы жолдар мен руналар: қазақ әрпі неге екі байт
Go курсының жетінші сабағы. len("шаңырақ") неге 7 емес, 14 қайтарады, байт пен әріптің айырмашылығы неде және руна деген не. Жолды range арқылы аралау, әріпті utf8.RuneCountInString арқылы дұрыс санау және басты тұзақ: жолды байтпен қиғанда қазақ әрпі қақ жарылады.
Не үшін керек
Сізге тақырыптың ұзындығын санау, аңдатпаны жүз таңбаға дейін қысқарту, аттың бос емесін тексеру керек болады. Ағылшынша мұның бәрі айқын жолмен істеледі — ал қазақша сол жол қате жауап береді.
len("шаңырақ") // 14, ал әріп жетеу
Бұл Go-ның қыңырлығы емес. Мәтін кез келген бағдарламалау тілінде осылай сақталады; Go тек мәселе жоқ сияқты көрсетпейді.
Бірден тұтас
Жаңа қалта, go mod init sabaq06, main.go:
package main

import (
	"fmt"
	"unicode/utf8"
)

func main() {
	word := "Go тілі"

	fmt.Println("байт:", len(word))
	fmt.Println("әріп:", utf8.RuneCountInString(word))

	for i, r := range word {
		fmt.Printf("%d\t%c\n", i, r)
	}

	fmt.Printf("бес байтпен қиғанда: %q\n", word[:5])
}
Іске қоспас бұрын — төменге қарамай, оның не басып шығаратынын дауыстап айтыңыз. Содан кейін жіберіп, салыстырыңыз: айырма шыққан жер — тілді әлі білмейтін тұсыңыз.
go run . мынаны басады:
байт: 11
әріп: 7
0	G
1	o
2
3	т
5	і
7	л
9	і
бес байтпен қиғанда: "Go т"
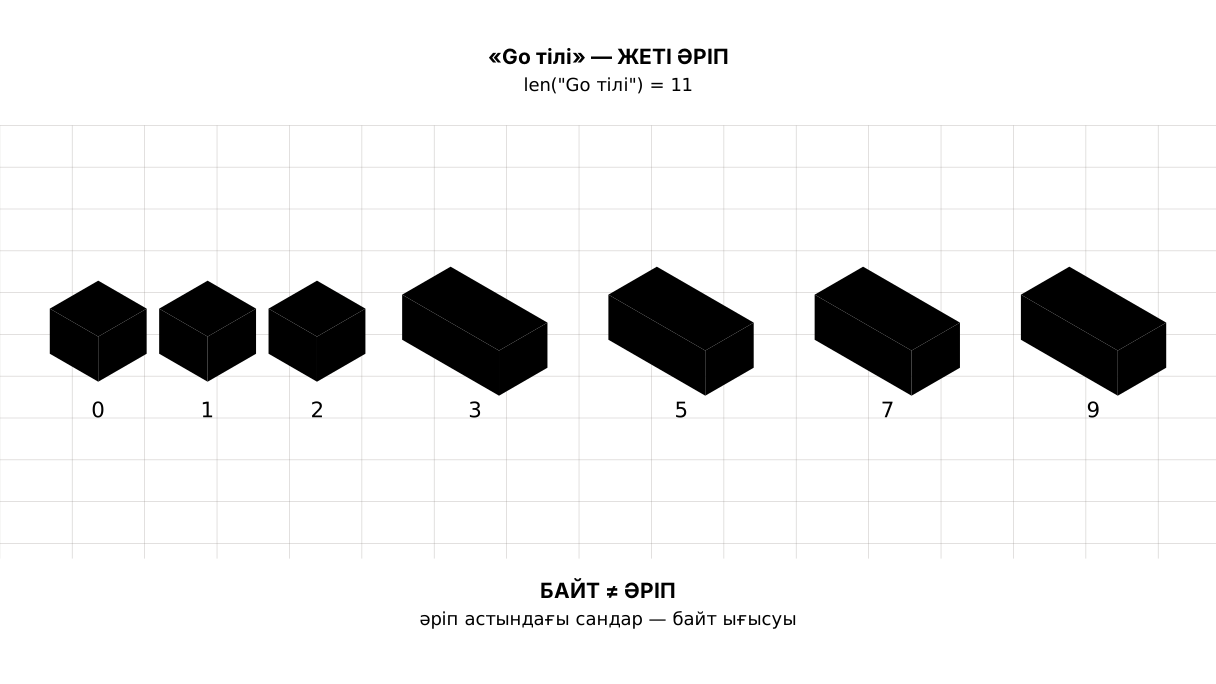
Сол жақ бағанға қараңыз: 0, 1, 2, 3, 5, 7, 9. Төрт пен алты жоқ.
Талдау
Жол — бұл байттар
Go-дағы жол — әріптер емес, байттар тізбегі. Латын әрпі бір байт алады, қазақ пен орыс әрпі — екі, иероглиф — үш, ал эмодзи төртке дейін жетеді.
Елестетіп көріңіз. Ені әртүрлі әріптер жапсырылған таспа.
lenтаспаны сантиметрмен өлшеп, қаншасы бар екенін адал айтады. Тек сантиметр — әріп емес және ешқашан болған да емес.
Бұл UTF-8 деп аталады — әлемнің кез келген әліпбиін бір кодтаумен жазу тәсілі. Ондағы латын әрпі бір байт алады, ескі мәтіндер семірмесін деп; оның есесіне қалған әліпбилер екі және одан көп байтпен төлейді.
len байтты санайды — және дұрыс істейді
len("Go тілі") 11 қайтарады. Қате емес: «қанша орын алады» мен «қанша әріп» — екі бөлек сұрақ, len біріншісіне жауап береді. Файл көлемін есептегенде немесе қойма шегін тексергенде сізге дәл байт керек.
Руна — таңбаның нөмірі
rune — Unicode деген жалпыәлемдік тізімдегі таңбаның нөмірі. rune типі — бұл int32, яғни жай ғана сан.
Елестетіп көріңіз. Әріптердің дүниежүзілік санағы. «қ» әрпінің сол тізімде өз нөмірі бар, үйдің мекенжайы болғандай. Руна — әріптің өзі емес, оның нөмірі; басып шығару үшін оны қайта жолға айналдырады.
Жалғыз руна жалғыз тырнақшаға алынады: 'қ' — руна, "қ" — бір әріптен тұратын жол. Екі бөлек нәрсе.
Жол бойынша range
for i, r := range word {
range жолды байттап емес, Unicode код нүктелері бойынша аралайды және әр қадамда екі нәрсе береді: i — басынан бергі байт ығысуы, r — руна.
Индекстердің неге секіргені содан: 3-орында тұрған т-дан кейінгі әріп 5-те қалды, өйткені т екі байт алды. Индекс — таспадағы мекенжай, әріптің реттік нөмірі емес.
Әріпті қалай санау керек
utf8.RuneCountInString(word) // 7
Стандартты кітапханадағы unicode/utf8 пакеті, орнататын ештеңе жоқ. «120 таңба қалды» деп көрсеткенде сізге дәл осы керек.
Кейін таңданбау үшін бір ескертпе. Руна — Unicode-тағы нөмір, көзге көрінетін бір таңба екеніне кепілдік жоқ. Кәдімгі қазақ және орыс мәтіні үшін руна мен әріп бір-біріне сай келеді, тыныш санауға болады. Бірақ e мен жеке белгіден құралған é — бір көрінетін таңбаға екі руна, ал бір отбасы эмодзиі — тұтас жетеу. Мұны тек сондай мәтін шынымен кездесетін жерде байқайсыз: аттарда және оқырман жазған мәтінде.
Тұзақ: байтпен қию
Міне, сабақ соның үшін жазылған:
word := "шаңырақ"
fmt.Println(word[:5])
Сіз бес байт сұрадыңыз, Go дәл бесеуін берді. Бірақ бесінші байт — «ң» әрпінің бірінші жартысы, сондықтан экранда оның орнына қоқыс шығады: ша\xd2.
Елестетіп көріңіз. Сөзді қайшымен әріптің арасынан емес, әріптің дәл ортасынан қию. Екі жартысы да бар, ал сөз жоқ.
Аңдатпалар осылай бұзылады: «сипаттаманы 200 таңбаға дейін қысқартамыз» дегені әрбір екінші қазақ мақаласында шолақ құйрыққа айналады. Дұрысы — әріппен санау:
r := []rune(word)
fmt.Println(string(r[:5]))   // шаңыр
[]rune(word) жолды руналарға жіктейді. Бұл бүкіл жол бойынша бөлек өту, сондықтан цикл ішінде олай істеудің қажеті жоқ, — ал бір рет қию үшін қалыпты.
Мұны іс жүзінде не істеу керек
Жолдарды қосуға және салыстыруға болады: "Go" + " тілі" жұмыс істейді, == жолды тұтас, байтпен байт салыстырады. Байт тек индекс алғанда, қиғанда және ұзындықты санағанда шығады. Ереже қарапайым: көлемге — len, әріпке — RuneCountInString, аралауға — range.
Сабақ картасы
Өз сөзіңізбен айтыңыз
Қарамай, дауыстап немесе қағазға жазып жауап беріңіз. Жауаптары — сабақтың соңында.
rangeарқылы аралағанда индекстер неге 0, 1, 2, 3, 5, 7, 9 болып жүрді?'қ'пен"қ"айырмашылығы неде?- Оқырман «Әсел» деген атты енгізіп, санауыш 4-тің орнына 8 таңба көрсетті деп шағымданды. Не болды?
Тапсырма
Міндетті. letters(s string) int функциясын жазыңыз — жолдағы әріп санын қайтарады, және bytes(s string) int — байт санын қайтарады. Екеуін де "шаңырақ", "Salem" және "Go тілі" үшін шақырып, сан жұптарын басып шығарыңыз.
Қалауыңызша.
cut(s string, n int) stringфункциясы: жолдыnәріпке дейін, соңғысын бұзбай қысқартады."шаңырақ"пенn = 5үшін тексеріңіз."шаңырақ"сөзінrangeарқылы аралап, әр әріпті Unicode нөмірімен басып шығарыңыз:fmt.Printf("%c = %d\n", r, r).len("Әсел")менlen("Asel")салыстырыңыз. Айырма неге дәл сондай?
Блогта қайда тұрады
Оқу уақытын бағалау, аңдатпаны карточканың сегіз жолына дейін қысқарту, «тақырып алпыс таңбадан ұзын емес» дегенді тексеру — мұның бәрі байтты емес, әріпті санайды. Осы жерде қателессеңіз, әр мақаланың қазақ нұсқасы сөздің ортасынан қиылады, ал ағылшын нұсқасы ештеңе болмағандай жұмыс істей береді. Мұндай қатені тек латынмен жазатын адам көрмейді.
Өз блогыңызды жинаңыз. Енді блог беті әріпті де, оқу уақытын да санай алады. Осы сабақтан кейінгі күйі — step-2: тақырып, әріп саны,
readingTimeжәнеif. Онда сіз әлі өтпеген ештеңе жоқ.
Жауаптар
Жауаптарды көрсету
- Себебі
i— әріптің реттік нөмірі емес, жолдың басынан бергі байт ығысуы.G,oжәне бос орын бір-бір байттан алды, сондықтан қатар жүрді; әр қазақ әрпі екі байт алады, сондықтан әрі қарай санақ бір аттап кетті. - Жалғыз тырнақшадағы
'қ'— руна, яғни сан, Unicode-тағы әріптің нөмірі. Қос тырнақшадағы"қ"— жол, яғни байттар тізбегі, бұл жағдайда екеуі. Біріншісін санмен, екіншісін жолмен қосуға болады. - Санауыш әріпті емес, байтты санаған. «Әсел» ішінде төрт әріп, бірақ «Ә», «с», «е» және «л» — кириллица, әрқайсысы екі байт, барлығы сегіз.
utf8.RuneCountInStringкерек.
Пікірлер (0)
Пікір қалдыру үшін кіріңіз →
Әзірге пікір жоқ. Бірінші болыңыз.