

Python: от данных до своей сводки Урок 47 из 56
Где кончается модель
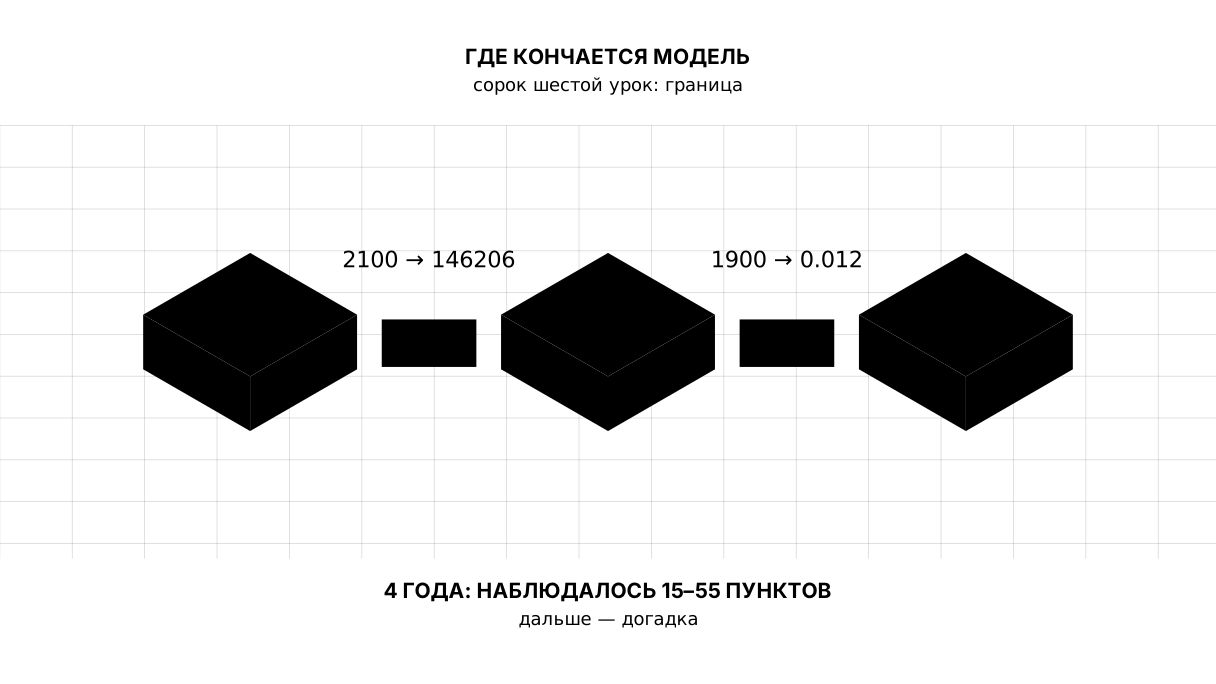
Сорок шестой урок курса по Python и конец модуля про модели. Та же прямая обещает индекс 146 206 на 2100 год и минус тысячу на 1800-й — и ни один ответ не помечает как сомнительный. Границу модели приходится дописывать руками: чему училась, где проверена, за каким годом не применима.
Зачем это нужно
Модель отвечает всегда. Это её главное свойство и главная опасность: спросите про 2100 год — получите число, спросите про 1800-й — тоже получите, и оба будут выглядеть одинаково уверенно.
Три прошлых урока учили считать ошибку. Этот — про то, что остаётся сказать словами, когда всё посчитано: чего модель не видела, о чём не знает в принципе и где кончается область, в которой ей вообще можно задавать вопросы.
Сразу целиком
Файл granica.py. Ряды настоящие: индексы цен Казахстана, Швейцарии и Японии, Всемирный банк, у всех 2010 = 100. Модель — та же прямая по логарифму, что в сорок третьем уроке.
"""Урок 46: где кончается модель.

Ряды настоящие: индексы потребительских цен Казахстана, Швейцарии и Японии,
2010 = 100, показатель FP.CPI.TOTL Всемирного банка. Модель — та же прямая
по логарифму, что в сорок третьем уроке.
"""

import numpy as np
import pandas as pd
from sklearn.linear_model import LinearRegression

KAZAKHSTAN = pd.Series({
    2010: 100.00, 2011: 108.45, 2012: 114.09, 2013: 120.87, 2014: 129.15,
    2015: 137.77, 2016: 157.56, 2017: 169.28, 2018: 179.72, 2019: 189.30,
    2020: 202.02, 2021: 218.27, 2022: 251.07, 2023: 287.54, 2024: 312.53,
    2025: 348.12,
})
# Те же годы, другие страны: у всех трёх 2010 = 100, поэтому числа сравнимы.
SWITZERLAND = pd.Series({2010: 100.00, 2015: 98.17, 2020: 98.82, 2025: 105.67})
JAPAN = pd.Series({2010: 100.00, 2015: 103.59, 2020: 105.46, 2025: 118.04})


def trained_on(series):
    """Прямая по логарифму индекса. Возвращает функцию «спроси про год»."""
    model = LinearRegression().fit(
        ((series.index.to_numpy() - 2010) / 10).reshape(-1, 1),
        np.log(series.to_numpy()))
    return lambda years: np.exp(
        model.predict(((np.array(years) - 2010) / 10).reshape(-1, 1)))


ask = trained_on(KAZAKHSTAN)

print("== Модель отвечает всегда")
for year in (2030, 2040, 2100):
    print(f"  {year}: {ask([year])[0]:.1f}")
for year in (1990, 1900):
    print(f"  {year}: {ask([year])[0]:.3f}")
print("  ни одного из этих ответов она не пометила как сомнительный")

print()
print("== Она не знает о том, чего не видела")
quiet = trained_on(KAZAKHSTAN[KAZAKHSTAN.index <= 2019])
for year in (2022, 2025):
    guess = float(quiet([year])[0])
    print(f"  {year}: обещано {guess:.1f}, на деле {KAZAKHSTAN[year]:.2f}"
          f" — промах {KAZAKHSTAN[year] - guess:.1f}")
print("  модель училась на тихих годах, а 2022-й был не тихий")

print()
print("== Она не знает, о какой стране речь")
guess_2025 = float(ask([2025])[0])
other = pd.DataFrame({
    "на деле 2025": [KAZAKHSTAN[2025], SWITZERLAND[2025], JAPAN[2025]],
    "модель обещает": [round(guess_2025, 1)] * 3,
}, index=["Казахстан", "Швейцария", "Япония"])
other["промах"] = (other["на деле 2025"] - other["модель обещает"]).round(1)
print(other.to_string())
print("  признак у модели один — год; страны среди признаков нет")

print()
print("== Одно число против диапазона")
past = KAZAKHSTAN.index <= 2021
checked = trained_on(KAZAKHSTAN[past])
errors = (KAZAKHSTAN[~past] - checked(KAZAKHSTAN[~past].index.to_numpy())).abs()
print(errors.round(1).to_string())
print(f"  среднее: {errors.mean():.1f}; наблюдалось на четырёх годах:"
      f" от {errors.min():.0f} до {errors.max():.0f} пунктов")

print()
print("== Чего в модели нет вовсе")
model = LinearRegression().fit(
    ((KAZAKHSTAN.index.to_numpy() - 2010) / 10).reshape(-1, 1),
    np.log(KAZAKHSTAN.to_numpy()))
print("  признаков на входе:", model.n_features_in_)
print("  среди них нет: чем мерили индекс, кто пересматривал ряд,")
print("  что стоит ошибка и кому этот ответ нужен")
Вывод:
== Модель отвечает всегда
  2030: 487.0
  2040: 1100.2
  2100: 146206.2
  1990: 18.701
  1900: 0.012
  ни одного из этих ответов она не пометила как сомнительный

== Она не знает о том, чего не видела
  2022: обещано 238.4, на деле 251.07 — промах 12.6
  2025: обещано 297.2, на деле 348.12 — промах 50.9
  модель училась на тихих годах, а 2022-й был не тихий

== Она не знает, о какой стране речь
           на деле 2025  модель обещает  промах
Казахстан        348.12           324.0    24.1
Швейцария        105.67           324.0  -218.3
Япония           118.04           324.0  -206.0
  признак у модели один — год; страны среди признаков нет

== Одно число против диапазона
2022    15.1
2023    33.9
2024    39.9
2025    55.1
  среднее: 36.0; наблюдалось на четырёх годах: от 15 до 55 пунктов

== Чего в модели нет вовсе
  признаков на входе: 1
  среди них нет: чем мерили индекс, кто пересматривал ряд,
  что стоит ошибка и кому этот ответ нужен
Разбор
Модель отвечает всегда
  2100: 146206.2
  1900: 0.012
Ни одно из этих чисел модель не пометила. Она не умеет: predict — это подстановка числа в формулу, а у формулы нет понятия «слишком далеко».
Индекс 0.012 на 1900 год означает, что тогда всё стоило в восемь тысяч раз дешевле, чем в 2010-м. В разминке прямая без логарифма выдаёт для 1800 года минус тысячу восемьсот — отрицательный индекс цен, вещь невозможная. Модель на это не жалуется, потому что жаловаться нечем: проверка на смысл — не её часть.
Она не знает о том, чего не видела
  2022: обещано 238.4, на деле 251.07 — промах 12.6
  2025: обещано 297.2, на деле 348.12 — промах 50.9
Прямая, обученная на тихих 2010–2019 годах, описывает тихий мир. 2022-й в этот мир не помещается, и дальше ошибка только растёт: то, чего в данных не было, модель не выдумает.
Это не лечится ни сложностью, ни количеством данных того же рода. Лечится только тем, что смену режима называют вслух: «модель описывает годы без шоков».
Она не знает, о какой стране речь
           на деле 2025  модель обещает  промах
Казахстан        348.12           324.0    24.1
Швейцария        105.67           324.0  -218.3
У модели один признак — год. Страны среди признаков нет, поэтому на вопрос «каким будет индекс Швейцарии в 2025-м» она отвечает казахстанским числом, и ошибается в три раза.
Звучит как очевидность, но именно так выглядит большинство настоящих ошибок: модель применяют к данным, похожим по форме — те же годы, тот же индекс, — и забывают, что обучена она была на другом.
Одно число против диапазона
2022    15.1
2025    55.1
  среднее: 36.0; наблюдалось на четырёх годах: от 15 до 55 пунктов
Средняя ошибка удобна для сравнения моделей. На четырёх проверочных годах наблюдались абсолютные ошибки от 15 до 55 пунктов, средняя — 36. Это описание всего четырёх наблюдений, а не прогнозный интервал: следующая ошибка может выйти за эти границы.
Поэтому в отчёте нужно назвать и среднюю ошибку, и наблюдавшийся диапазон, и число проверочных лет. Нельзя выдавать минимум и максимум четырёх ошибок за гарантированные будущие границы.
Чего в модели нет вовсе
признаков на входе: 1
Всё, что урок сорок первый рассказывал про пересмотры и определения, в модель не входит. Всё, что урок сорок пятый говорил про цену ошибки, тоже: модель не знает, чем ложная тревога отличается от пропуска, потому что ей не сказали, кто и зачем спрашивает.
Это не изъян конкретной прямой. Это граница всего класса: модель знает ровно те столбцы, которые ей дали, и ничего больше.
Что писать рядом с числом
Короткая строка, которая закрывает модуль:
индекс цен, модель обучена на 2010–2021, ошибка на проверке 15–55 пунктов, за 2021 годом не применима
Четыре факта: что считает, на чём училась, сколько ошибается, где кончается. Такую строку можно поставить под любым числом в отчёте, и в задании её собирает программа — из измерений, а не из вежливости.
Карта урока
Скажите своими словами
Ответьте вслух или на бумаге, не подглядывая. Ответы — в конце урока.
- Почему модель не предупреждает, что 2100 год — это слишком далеко?
- Что значит «модель не знает, о какой стране речь», если данные того же вида?
- Почему в отчёт идёт диапазон ошибки, а не среднее?
Разминка
Три коротких шага перед заданием: предсказать, дополнить, починить. Ответы — в конце урока, но сначала ответьте сами.
1. Предскажите. Что напечатает программа для 1800 года?
import numpy as np
from sklearn.linear_model import LinearRegression

years = np.array([[2020], [2021], [2022], [2023]])
index = np.array([100.0, 108.0, 117.0, 126.0])
model = LinearRegression().fit(years, index)
print("2024:", round(float(model.predict(np.array([[2024]]))[0]), 1))
print("1800:", round(float(model.predict(np.array([[1800]]))[0]), 1))
2. Заполните пропуск. Вместо ... проверьте, видела ли модель такой год.
# модель отвечает только про те годы, которые видела
first, last = 2010, 2021
for year in (2015, 2030):
    known = ...
    print(year, "внутри данных" if known else "за краем данных")
3. Почините. Программа печатает предсказание на 2025 год так, будто это измерение.
# рядом с ответом — на чём училась и до какого года применима
answer, first, last = 293.1, 2010, 2021
print(f"2025: {answer}")
Задание
Обязательное. Соберите паспорт модели: на каких годах училась и сколько там точек, на каких проверялась и в каком диапазоне ошибается, сколько у неё признаков и где кончается область применения. Затем сделайте так, чтобы модель отвечала только про известные годы, а на остальные говорила «за краем данных» — и покажите, что она ответила бы без этой границы. В конце соберите одну строку для отчёта, целиком из измеренного.
Ожидаемый вывод:
== Паспорт модели
  училась: 2010-2021, точек 12
  проверялась: 2022-2025, ошибка от 15 до 55 пунктов
  признаков на входе: 1
  область применения: 2010-2021 — дальше начинается догадка

== Ответы внутри и снаружи
  2015: 142.3
  2021: 219.5
  2025: за краем данных, модель видела 2010-2021
  2030: за краем данных, модель видела 2010-2021

== Что было бы без границы
  2025: 293.1
  2030: 420.5
  2100: 66029.9
  те же числа, только теперь видно, что это экстраполяция

== Честная строка для отчёта
  индекс цен, модель обучена на 2010-2021, ошибка на проверке 15-55 пунктов, за 2021 годом не применима
Готово — это: вывод совпадает построчно; граница живёт в коде модели, а не в голове того, кто её зовёт; за край можно выйти только явным аргументом; строка для отчёта собирается из чисел, а не набирается руками.
На своих данных. Возьмите любую свою модель — хоть среднее по месяцу — и напишите под ней такую же строку из четырёх фактов. Если хотя бы один из них не удаётся заполнить числом, это и есть место, где модель кончается раньше, чем вы думали.
По желанию.
- Добавьте в паспорт долю лет, где ошибка превысила десять пунктов: одно число, которое честнее среднего.
- Сделайте, чтобы
askвозвращала не число, а пару «ответ, предупреждение» — и посмотрите, как изменится код, который её зовёт. - Обучите модель на Швейцарии и спросите её про Казахстан. Ошибка будет зеркальной, и это хороший способ убедиться, что дело не в стране, а в том, чего модель не знает.
Куда это встанет в проекте
Шаг двадцать четвёртый, последний в модуле: сводка пишет, чего она не говорит.
Внизу страницы появляется список, и ни одна его строка не набрана руками. esep.shekteu берёт каждое число из той таблицы, которая его посчитала:
 • прогноза нет: тренд на своих годах ошибается до 3.55 пункта
 • связь цен и денег не посчитана: 2 страны, нужно 8
 • страна без денежной массы: RUS
 • годы: до 2025; о следующем годе отчёт не говорит ничего
Смысл именно в том, что список собран из данных. Оговорку, написанную однажды в подвале, через полгода никто не перечитывает, и она начинает врать первой. Строка, которая берёт свою цифру из таблицы над собой, меняется вместе с ней.
Это самая дешёвая часть всей сводки — одна функция и четыре строки на странице. И это то, чем отчёт отличается от утверждения.
Ответы
Показать ответы
На вопросы
- Потому что
predict— подстановка в формулу, а у формулы нет понятия расстояния от данных. Границу знает не модель, а тот, кто её обучал; если он её не записал, её нет нигде. - Что признак «страна» в модель не входит: она видела только год и индекс Казахстана. Похожие по форме данные — те же годы, тот же вид индекса — не делают её моделью Швейцарии, и ошибка в 218 пунктов это показывает.
- Потому что среднее звучит как измерение, а на четырёх годах ошибка разошлась от 15 до 55 пунктов. Диапазон говорит то, что есть; среднее говорит больше, чем известно.
К разминке
- Прямая уходит вниз влево бесконечно, поэтому для 1800 года она даёт отрицательный индекс цен — величину, которой не бывает. Модель об этом не знает.
2024: 134.5
1800: -1814.3
first <= year <= last. Граница — это сравнение с тем, что видела модель, а не догадка того, кто её зовёт.
# модель отвечает только про те годы, которые видела
first, last = 2010, 2021
for year in (2015, 2030):
    known = first <= year <= last
    print(year, "внутри данных" if known else "за краем данных")
2015 внутри данных
2030 за краем данных
- Число само по себе ничего не говорит о том, откуда взялось. Рядом с ним ставят годы обучения и пометку, что это экстраполяция.
# рядом с ответом — на чём училась и до какого года применима
answer, first, last = 293.1, 2010, 2021
print(f"2025: {answer} (модель обучена на {first}-{last}, это экстраполяция)")
2025: 293.1 (модель обучена на 2010-2021, это экстраполяция)
К заданию
Главное в задании — что граница живёт внутри ask, а не в памяти того, кто её вызывает. Модель, которая сама отказывается отвечать про 2030 год, защищает не себя, а того, кто через полгода возьмёт этот код и не станет читать, на чём он учился.
И обратите внимание на блок «что было бы без границы»: те же самые числа, 420.5 и 66029.9, никуда не делись и по-прежнему доступны — но теперь за ними нужно прийти с явным аргументом. Разница между «модель сказала» и «я попросил её выйти за край» стоит одной строки кода.
Источники
- LinearRegression, scikit-learn —
predict, у которого нет понятия «слишком далеко». - Model Cards for Model Reporting — статья, с которой пошла привычка писать паспорт модели: на чём училась, где проверена, где не применима.
- Индекс потребительских цен, Всемирный банк — ряды трёх стран, на которых построен урок.
Если вы нашли ошибку или опечатку в тексте статьи, то сообщите нам об этом
Комментарии (0)
Войдите, чтобы оставить комментарий →
Пока нет комментариев. Будьте первым.