

Python: от данных до своей сводки Урок 52 из 56
Чего нельзя доверять модели: факт, вывод и причина
Пятьдесят первый урок курса по Python. Разделяем наблюдение, вычисленный вывод и объяснение причины. Код может подтвердить число и воспроизвести расчёт, но правдоподобная причинная история остаётся гипотезой, пока у неё нет отдельного источника и человеческой проверки.
Зачем это нужно
В уроке 50 модель уже не могла подменить число: программа сверяла его с source_id. Но из правильного числа легко получить неправильную историю:
Инфляция составила 11,4 %, потому что выросла денежная масса.
Первая часть может быть в таблице. Слово «потому что» добавляет причинную связь, которой одна строка не доказывает. Модель умеет подобрать убедительное объяснение, но убедительность не является свидетельством.
Нужны три разных вида утверждений:
- наблюдение — значение прямо есть в источнике;
- вычисленный вывод — результат повторяемого кода, например разница двух значений;
- причина — утверждение о том, почему произошло изменение; оно требует отдельного исследования или источника.
Сразу целиком
Файл trust.py применяет правило допуска. Модель классифицирует предложение, но окончательное право задаёт код.
"""Урок 51: причинная история не проходит как наблюдение."""

EVIDENCE = {"inflation-kz-2025", "inflation-kz-2024"}


def decide(candidate):
    """Вернуть решение, не пытаясь угадать истинность красивого текста."""
    missing = set(candidate["evidence_ids"]) - EVIDENCE
    if missing:
        return "reject", "неизвестный источник"
    if candidate["claim_type"] == "cause":
        return "review", "причина требует отдельного доказательства"
    if candidate["claim_type"] == "calculation":
        return "review", "нужна воспроизводимая формула"
    if candidate["claim_type"] == "observation":
        return "accept", "значение сверяется с источником"
    return "reject", "неизвестный тип"


candidates = [
    {
        "text": "Инфляция в Казахстане имеет опубликованное значение.",
        "claim_type": "observation",
        "evidence_ids": ["inflation-kz-2025"],
    },
    {
        "text": "Инфляция выросла из-за денежной массы.",
        "claim_type": "cause",
        "evidence_ids": ["inflation-kz-2025"],
    },
]

for candidate in candidates:
    decision, reason = decide(candidate)
    print(candidate["claim_type"], "->", decision, "—", reason)
Вывод:
observation -> accept — значение сверяется с источником
cause -> review — причина требует отдельного доказательства
Тип утверждения — часть данных
Поле claim_type должно быть ограничено схемой:
"claim_type": {
    "type": "string",
    "enum": ["observation", "calculation", "cause"],
}
Но модель может ошибочно назвать причину наблюдением. Поэтому её метка помогает маршрутизации, а не служит доказательством. Для автоматической публикации используйте узкий шаблон наблюдения, который код собирает из уже проверенных полей. Свободный текст отправляйте на проверку.
Корреляция не отвечает «почему»
Два ряда могут двигаться вместе из-за прямого влияния, обратного влияния, третьего фактора, общего тренда или случайности. Даже высокая корреляция не выбирает один из этих вариантов.
Эксперимент, естественный эксперимент, продуманный причинный дизайн или надёжный предметный источник могут поддержать причинное утверждение. Одна диаграмма и одна языковая модель — нет.
Слова потому что, вызвано, привело, благодаря полезны для предупреждения редактору, но простой список слов нельзя считать защитой: ту же причинность можно выразить иначе. Безопасная граница — не публиковать свободную причинную прозу автоматически.
Что делать с неопределённостью
У системы должно быть не два, а как минимум три решения:
accept— узкое наблюдение собрано кодом из проверенных данных;review— утверждение может быть полезно, но требует человека или дополнительного источника;reject— структура, тип или ссылка на источник нарушены.
review — не замаскированное одобрение. Такой текст не попадает в отчёт до решения человека.
Не просите модель судить саму себя
Второй запрос «проверь, не выдумал ли ты» может поймать часть ошибок, но остаётся ответом модели. Он полезен как дополнительный сигнал, а не как независимая проверка.
Независимая проверка опирается на другое: исходную запись, выполняемый расчёт, внешний документ или человека, который отвечает за публикацию.
Карта урока
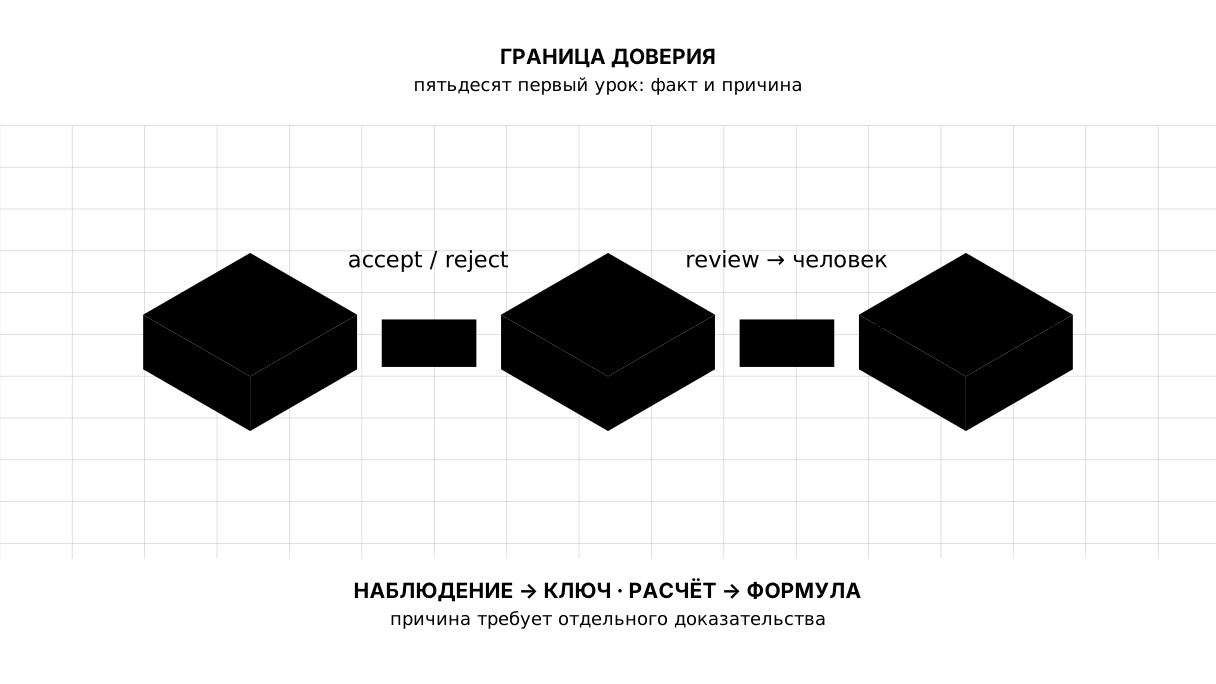
Восстановите опорный сигнал: наблюдение → источник; расчёт → формула; причина → отдельное доказательство и человек.
Скажите своими словами
- Почему правильное число не делает правильным объяснение его причины?
- Чем вычисленный вывод отличается от наблюдения?
- Почему метке
claim_type, которую поставила модель, нельзя верить безусловно? - Что означает решение
reviewдля публикации?
Разминка
1. Предскажите. Какой тип у фразы «значение выросло из-за спроса»?
text = "значение выросло из-за спроса"
print("cause" if "из-за" in text else "observation")
2. Заполните пропуск. Разрешите только три известных типа.
schema = {"type": "string", ...: ["observation", "calculation", "cause"]}
3. Почините. Причина сейчас автоматически публикуется.
if candidate["evidence_ids"]:
    publish(candidate["text"])
Задание
Обязательное. Напишите route(candidates, known_ids). Наблюдение с известными источниками получает accept, причина — review, вычисление без formula_id — review, а неизвестный источник или тип — reject. Посчитайте решения.
accept: 1
review: 2
reject: 2
публикуется: ['obs-1']
На своих данных. Напишите по одному наблюдению, вычисленному выводу и причинной гипотезе о сводке. Рядом укажите, какое доказательство нужно каждому.
По желанию. Добавьте очередь ручной проверки: храните текст, причины маршрутизации, идентификаторы источников и решение редактора, но не публикуйте запись со статусом review.
Куда это встанет в проекте
Модуль ИИ завершён: запрос воспроизводим, JSON проверяется, числа сверяются, а причинная проза не проходит автоматически. Следующий урок начинает модуль инженерной надёжности и собирает эти правила в тесты pytest.
Ответы
Показать ответы
- Число подтверждает наблюдение, но не механизм, который к нему привёл.
- Наблюдение хранится в источнике, а вывод должен воспроизводиться указанной формулой.
- Классификация сама является непроверенным результатом модели.
- Текст удерживается вне публикации до отдельной проверки.
cause
- Ключ —
"enum".
schema = {"type": "string", "enum": ["observation", "calculation", "cause"]}
print("cause" in schema["enum"])
True
- Маршрутизируйте причину на проверку.
candidate = {"claim_type": "cause", "text": "Спрос вызвал рост."}
decision = "review" if candidate["claim_type"] == "cause" else "accept"
print(decision)
review
Источники
- NIST AI Risk Management Framework — управление достоверностью и рисками ИИ.
- OWASP: misinformation — правдоподобные ложные ответы и независимая проверка.
- The Book of Why, Pearl and Mackenzie — различие наблюдения и причинного вывода.
Если вы нашли ошибку или опечатку в тексте статьи, то сообщите нам об этом
Комментарии (0)
Войдите, чтобы оставить комментарий →
Пока нет комментариев. Будьте первым.