

Python: от данных до своей сводки Урок 17 из 56
Свой модуль и пакет: `import`, `__name__` и файл, который подменил стандартный
Семнадцатый урок курса по Python. Сводка выросла до одного длинного файла, и пора разложить её по именам. `import` выполняет чужой файл целиком, `__name__` отличает модуль от запущенного, а свой `csv.py` рядом с программой молча заменяет стандартный.
Зачем это нужно
Программа сводки выросла. В одном файле лежат расчёт, чтение выгрузки, печать отчёта — и чтобы найти нужное имя, файл прокручивают.
Разложить по файлам — не про красоту. Это про то, чтобы у каждого куска было имя, которое можно позвать: sana.average(...) читается сразу, а «функция где-то в середине файла» — нет.
Заодно выясняется, что import делает больше, чем кажется: он выполняет чужой файл целиком, один раз, и запоминает результат.
Сразу целиком
Файл modul.py. Запуск: python modul.py из окружения.
Обычно модули пишет человек — один раз, руками. Здесь их пишет сама программа: так урок запускается одной командой, и видно не только код, но и что из него вышло. Обязательное — первые два блока: импорт модуля и импорт из пакета.
"""Урок 17: модуль — файл, который зовут по имени.

Сводка выросла: расчёт, чтение файла, печать отчёта лежат в одном файле, и имя
в нём ищут прокруткой. Пора разложить по файлам — и узнать, что происходит при
`import` на самом деле.
"""

import importlib
import shutil
import sys
from pathlib import Path

HERE = Path(__file__).parent

# Обычно эти файлы пишет человек. Здесь их пишет программа: так урок можно
# запустить одной командой и увидеть, что получилось.
(HERE / "sana.py").write_text('''"""Расчёты сводки: одно дело — одно место."""

ROUND_TO = 2


def average(values):
    """Среднее по ряду; пропуски не в счёт."""
    numbers = [value for value in values if value is not None]
    return round(sum(numbers) / len(numbers), ROUND_TO)


print("   (файл sana.py выполняется при импорте, __name__ =", __name__, end=")\\n")

if __name__ == "__main__":
    print("   этот кусок работает только при прямом запуске")
''', encoding="utf-8")

package = HERE / "svodka"
package.mkdir(exist_ok=True)
(package / "__init__.py").write_text('"""Пакет сводки: папка, которую можно импортировать."""\n', encoding="utf-8")
(package / "otchet.py").write_text('''"""Печать отчёта: то, что видит человек."""


def line(year, value):
    """Одна строка отчёта."""
    return f"{year}: {value:.1f}%"
''', encoding="utf-8")

importlib.invalidate_caches()

print("== импорт: файл становится именем")
import sana

print("имя модуля:", sana.__name__)
print("среднее:   ", sana.average([8.0, None, 15.0]))
print("константа: ", sana.ROUND_TO)

from sana import average

print("то же через from ... import:", average([1.0, 2.0]))

print()
print("== пакет: папка с __init__.py")
from svodka import otchet

print("имя модуля в пакете:", otchet.__name__)
print("строка отчёта:", otchet.line(2025, 11.4))

print()
print("== __name__ у запущенного файла")
print("здесь __name__ =", __name__)

print()
print("== два подвоха")
try:
    import sanaa
except ModuleNotFoundError as error:
    print("опечатка в имени:", error)

(HERE / "csv.py").write_text("MINE = True\n", encoding="utf-8")
importlib.invalidate_caches()
import csv

print("свой csv.py рядом:", getattr(csv, "MINE", False), "| csv.reader есть:", hasattr(csv, "reader"))
print("import смотрит сюда первым:", Path(sys.path[0]).name == HERE.name)

# Убираем за собой: файлы, пакет и кэш байт-кода.
for name in ("sana.py", "csv.py"):
    (HERE / name).unlink()
shutil.rmtree(package)
shutil.rmtree(HERE / "__pycache__", ignore_errors=True)
print("убрано, файлов рядом:", len(list(HERE.glob("*.py"))) - 1)
Выводит:
== импорт: файл становится именем
   (файл sana.py выполняется при импорте, __name__ = sana)
имя модуля: sana
среднее:    11.5
константа:  2
то же через from ... import: 1.5

== пакет: папка с __init__.py
имя модуля в пакете: svodka.otchet
строка отчёта: 2025: 11.4%

== __name__ у запущенного файла
здесь __name__ = __main__

== два подвоха
опечатка в имени: No module named 'sanaa'
свой csv.py рядом: True | csv.reader есть: False
import смотрит сюда первым: True
убрано, файлов рядом: 0
Разбор
import — это выполнение файла, а не «подключение»
(файл sana.py выполняется при импорте, __name__ = sana)
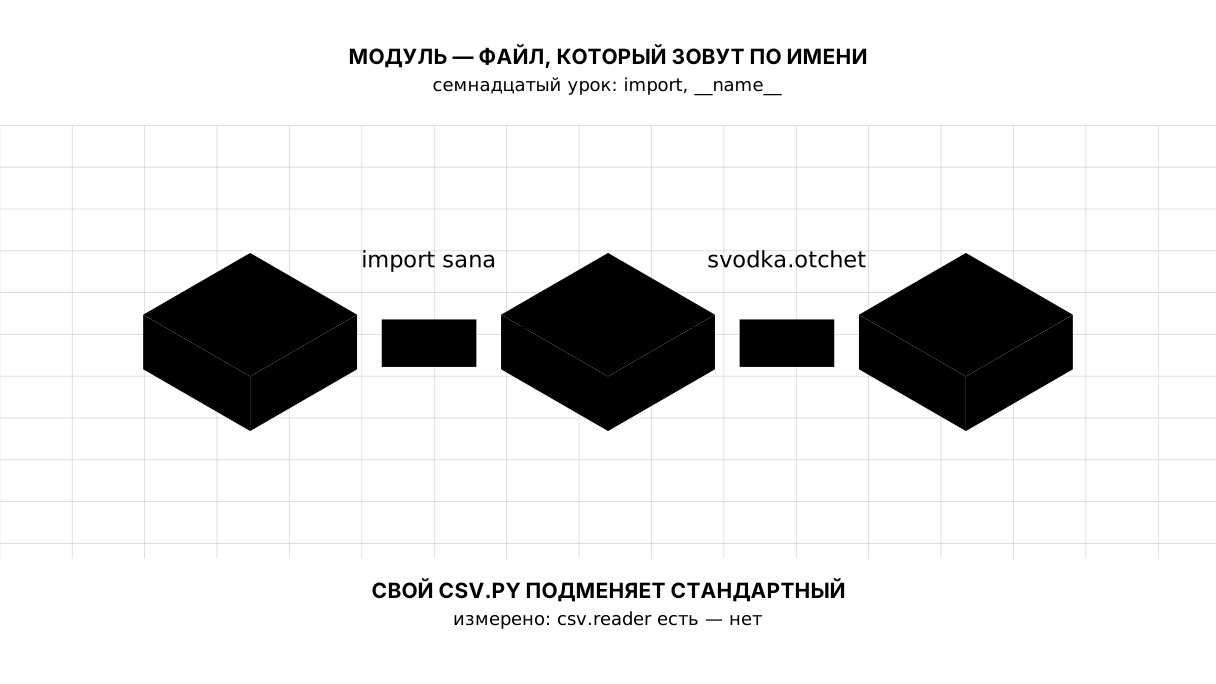
Строка напечаталась до того, как мы позвали хоть одну функцию. Потому что import sana — это «найди файл sana.py, выполни его целиком и положи получившиеся имена в объект-модуль».
Отсюда практическое правило: на верхнем уровне модуля держат определения, а не действия. Функции, классы, константы — да. Запросы в сеть, чтение файлов, печать — нет: всё это случится при импорте, у того, кто просто хотел взять одну функцию.
Выполняется файл один раз. Второй import sana в другом месте программы уже ничего не выполняет — Python отдаёт готовый модуль из sys.modules.
Образ. Полка с инструментами. Внести полку в комнату — не то же самое, что взять с неё молоток. Плохо, если полка при внесении сама начинает забивать гвозди.
__name__: кто я — модуль или программа
имя модуля: sana
здесь __name__ = __main__
У каждого файла есть переменная __name__. Если файл импортировали, в ней его имя — sana. Если файл запустили — там __main__.
Отсюда та самая строка, которая встречается в чужом коде чаще всех:
if __name__ == "__main__":
    main()
Она означает: «выполняй это, только когда файл запустили напрямую». Так один и тот же файл может быть и модулем, из которого берут функции, и программой, которую запускают. Без неё импорт модуля запускал бы всю его работу.
Две формы импорта
# берём модуль целиком: обращаемся sana.average(...)
import sana

# берём одно имя: обращаемся average(...)
from sana import average
Первая форма оставляет источник видимым в каждом вызове: sana.average — сразу понятно, откуда функция. Вторая короче, но в чужом файле average(...) уже не говорит, чьё оно.
Правило простое: берут модуль целиком, когда имён много или они общие (average, line, load есть у всех), и from ... import — когда имя редкое и его видно по названию. Звёздочку from sana import * не берут никогда: она вносит в файл всё подряд, включая то, что вы не называли.
Пакет — папка, которую можно импортировать
имя модуля в пакете: svodka.otchet
Пакет — это папка с файлами-модулями и файлом __init__.py внутри. Он может быть пустым: его роль — сказать «эта папка не просто папка, а пакет», и заодно быть местом, где пакет решает, что показывать наружу.
Обращаются через точку: from svodka import otchet, потом otchet.line(...). Имя модуля внутри пакета — полное: svodka.otchet.
Так у проекта появляется структура: svodka/otchet.py — печать, svodka/dannye.py — чтение, sana.py — расчёт. Каждое имя лежит там, где его будут искать.
Два подвоха
опечатка в имени: No module named 'sanaa'
ModuleNotFoundError — самая частая ошибка новичка, и у неё три причины: опечатка, файл лежит не рядом с программой, или вы не в том окружении. Проверяют в этом порядке — второй урок про это и был.
свой csv.py рядом: True | csv.reader есть: False
А это подвох дорогой. Python ищет модуль сначала рядом с запущенной программой, и только потом в стандартной библиотеке. Назовите свой файл csv.py, json.py, random.py — и import csv найдёт ваш файл, а не библиотеку.
Ошибка выглядит дико: «у модуля csv нет reader», хотя он там был вчера. Свежий Python подсказывает прямо в тексте ошибки: consider renaming '.../json.py' since it has the same name as the standard library module. Лечение одно — переименовать свой файл.
Карта урока
Скажите своими словами
Не подглядывая, ответьте вслух или на бумаге. Ответы — в конце урока.
- Что происходит в момент
import sanaи почему на верхнем уровне модуля не пишут действия? - Чему равно
__name__в импортированном файле и в запущенном? - Почему свой файл
csv.pyрядом с программой ломаетimport csv?
Разминка
Три коротких шага перед заданием: предсказать, дописать, починить. Ответы — в конце урока, но сначала ответьте сами.
1. Предскажите. Файл запустили напрямую. Что он напечатает?
def main():
    print("работает main")


if __name__ == "__main__":
    main()
2. Заполните пропуск. Вместо ... возьмите из pathlib одно нужное имя.
# допишите импорт одним нужным именем
from pathlib import ...

print(Path("dannye.csv").suffix)
3. Почините. Программа падает на json.dumps, хотя модуль стандартный и никуда не девался. Прочитайте ошибку и почините — переименованием.
# программа сама кладёт рядом с собой файл json.py — так же, как это делает
# человек, назвавший свой файл именем стандартного модуля
from pathlib import Path

HERE = Path(__file__).parent
(HERE / "json.py").write_text("MINE = True\n", encoding="utf-8")

import json

print(json.dumps({"year": 2025}))
Задание
Обязательное. Разложите расчёт по файлам. Дано:
series = {2023: 14.5, 2024: 8.7, 2025: 11.4, 2026: None}
Заведите модуль sana.py с двумя функциями: average(values) — среднее без пропусков — и above(series, limit) — список годов, где значение больше предела. Заведите пакет svodka/ с __init__.py и otchet.py, а в нём title(text) (заголовок заглавными) и line(year, value) (строка вида 2025: 11.4%). В главной программе импортируйте и то и другое и напечатайте отчёт, а последней строкой — имя модуля и имя самой программы.
Ожидаемый вывод:
ИНФЛЯЦИЯ
2023: 14.5%
2024: 8.7%
2025: 11.4%
2026: данных нет
среднее: 11.53
выше десяти: [2023, 2025]
модуль: sana | эта программа: __main__
Готово, когда: вывод совпадает построчно; в sana.py и в otchet.py нет ни одного print на верхнем уровне; отчёт печатает главная программа, а не модули; год без числа не попал ни в среднее, ни в список.
На своих данных. Возьмите свою программу из прошлых уроков и разнесите её на два файла: расчёт отдельно, печать отдельно. Запустите — и убедитесь, что при импорте расчёта ничего не печатается само.
Всё это собрано в step-6 — сверьтесь после того, как напишете сами.
По желанию.
- Добавьте в
sana.pyстрокуif __name__ == "__main__":с маленькой проверкой и запустите файл напрямую. - Напечатайте
sana.__file__и посмотрите, откуда Python его взял. - Положите рядом с программой файл
random.pyи попробуйтеimport random.
Куда это встанет в проекте
Сводка перестаёт быть одним файлом. Расчёт, чтение выгрузки и печать разъезжаются по своим местам, и каждое имя теперь зовут по адресу. Это первый шаг к тому, чтобы отдельные части можно было проверять по отдельности, — до тестов остаётся немного.
Долги. Мы не трогали sys.path и установку своего пакета через pip install -e .: пока хватает того, что модули лежат рядом с программой. И __init__.py у нас пустой — когда пакету будет что показывать наружу, это перестанет быть правдой.
Ответы
Показать ответы
На вопросы
- Python находит файл, выполняет его целиком и складывает получившиеся имена в объект-модуль; повторный импорт берёт готовое из
sys.modules. Поэтому действия на верхнем уровне сработают у того, кто просто хотел одну функцию. - В импортированном — имя файла (
sana), в запущенном —__main__. На этом и стоитif __name__ == "__main__":. - Потому что при импорте Python сначала смотрит рядом с запущенной программой и только потом в стандартной библиотеке. Ваш файл находится первым, и в нём, конечно, нет ни
reader, ниdumps.
К разминке
работает main. Файл запустили напрямую, значит__name__равно__main__, условие верно иmain()вызывается. Если бы этот же файл импортировали, не напечаталось бы ничего.
работает main
Path. Из модуля берут ровно то имя, которым потом пользуются;from pathlib import *внесло бы и всё остальное.
from pathlib import Path

print(Path("dannye.csv").suffix)
.csv
- Файл назван
json.pyи лежит рядом с программой, поэтомуimport jsonнаходит его, а не стандартный модуль:AttributeError: module 'json' has no attribute 'dumps' (consider renaming ...). Свой файл переименовывают:
from pathlib import Path

HERE = Path(__file__).parent
(HERE / "moi_json.py").write_text("MINE = True\n", encoding="utf-8")

import json

print(json.dumps({"year": 2025}))
(HERE / "moi_json.py").unlink()
{"year": 2025}
Источники
Если вы нашли ошибку или опечатку в тексте статьи, то сообщите нам об этом
Комментарии (0)
Войдите, чтобы оставить комментарий →
Пока нет комментариев. Будьте первым.