

Python: от данных до своей сводки Урок 29 из 56
Группировки и агрегаты: посчитать по категориям и по месяцам
Двадцать восьмой урок курса по Python. `groupby` — это цикл, написанный вопросом: разрезать таблицу по ключу, посчитать каждый кусок, собрать обратно. Разбираем `agg` со своими именами столбцов, два ключа, ключ, которого нет в таблице, `transform` для доли и группы, которые теряются молча.
Зачем это нужно
Предыдущий урок оставлял нужные строки. Этот отвечает на вопрос, ради которого их обычно и оставляют: сколько по каждой категории, по каждому городу, по каждому месяцу.
Циклом это пишется так: пустой словарь, проход по строкам, накопление, потом второй проход, чтобы посчитать средние. Мы писали такой цикл не раз — в шестом уроке он и был темой. groupby делает то же самое одной строкой, и главное в нём не краткость, а то, что вопрос виден целиком: по чему группируем и что считаем.
Если вы помните GROUP BY из двадцать второго урока — это он и есть, только над таблицей в памяти вашей программы.
Сразу целиком
Файл gruppy.py. Двенадцать чеков за два месяца и семь способов их сложить.
"""Урок 28: группировки и агрегаты.

Двенадцать чеков за два месяца. Считаем по категориям, по городам и по месяцам —
и ни одного цикла.
"""

import pandas as pd

rows = [
    ("2026-01-03", "Костанай", "еда", 4200),
    ("2026-01-05", "Костанай", "топливо", 18500),
    ("2026-01-07", "Рудный", "еда", 2600),
    ("2026-01-09", "Костанай", "связь", 4990),
    ("2026-01-15", "Костанай", "аренда", 95000),
    ("2026-01-18", "Рудный", "топливо", 16200),
    ("2026-01-24", "Костанай", "еда", 3100),
    ("2026-02-02", "Рудный", "еда", 2800),
    ("2026-02-06", "Костанай", "топливо", 19100),
    ("2026-02-11", "Костанай", "связь", 4990),
    ("2026-02-15", "Костанай", "аренда", 95000),
    ("2026-02-20", "Рудный", "аренда", 62000),
]
df = pd.DataFrame(rows, columns=["day", "city", "kind", "amount"])
df["day"] = pd.to_datetime(df["day"])

print("== сумма по категориям")
print(df.groupby("kind")["amount"].sum().sort_values(ascending=False))

print()
print("== три числа сразу")
print(df.groupby("kind")["amount"].agg(["count", "sum", "mean"]).round(0))

print()
print("== свои имена столбцов")
report = df.groupby("kind").agg(
    чеков=("amount", "count"),
    всего=("amount", "sum"),
    средний=("amount", "mean"),
).round(0)
print(report.sort_values("всего", ascending=False))

print()
print("== два ключа")
by_two = df.groupby(["city", "kind"])["amount"].sum()
print(by_two)
print("подписи:", type(by_two.index).__name__)

print()
print("== обратно в плоскую таблицу")
print(by_two.reset_index().head(3))

print()
print("== по месяцам: ключ, которого нет в таблице")
by_month = df.groupby(df["day"].dt.to_period("M"))["amount"].agg(["count", "sum"])
print(by_month)

print()
print("== count считает непустые значения, size — строки")
with_gap = df.copy()
with_gap.loc[6, "amount"] = None
print("count:", with_gap.groupby("kind")["amount"].count().to_dict())
print("size: ", with_gap.groupby("kind").size().to_dict())

print()
print("== доля категории внутри города")
df["доля"] = (df["amount"] / df.groupby("city")["amount"].transform("sum") * 100).round(1)
print(df.loc[df["city"] == "Рудный", ["kind", "amount", "доля"]].to_string(index=False))
Выводит:
== сумма по категориям
kind
аренда     252000
топливо     53800
еда         12700
связь        9980
Name: amount, dtype: int64

== три числа сразу
         count     sum     mean
kind
аренда       3  252000  84000.0
еда          4   12700   3175.0
связь        2    9980   4990.0
топливо      3   53800  17933.0

== свои имена столбцов
         чеков   всего  средний
kind
аренда       3  252000  84000.0
топливо      3   53800  17933.0
еда          4   12700   3175.0
связь        2    9980   4990.0

== два ключа
city      kind
Костанай  аренда     190000
          еда          7300
          связь        9980
          топливо     37600
Рудный    аренда      62000
          еда          5400
          топливо     16200
Name: amount, dtype: int64
подписи: MultiIndex

== обратно в плоскую таблицу
       city    kind  amount
0  Костанай  аренда  190000
1  Костанай     еда    7300
2  Костанай   связь    9980

== по месяцам: ключ, которого нет в таблице
         count     sum
day
2026-01      7  144590
2026-02      5  183890

== count считает непустые значения, size — строки
count: {'аренда': 3, 'еда': 3, 'связь': 2, 'топливо': 3}
size:  {'аренда': 3, 'еда': 4, 'связь': 2, 'топливо': 3}

== доля категории внутри города
   kind  amount  доля
    еда    2600   3.1
топливо   16200  19.4
    еда    2800   3.3
 аренда   62000  74.2
Разбор
Разрезать, посчитать, собрать
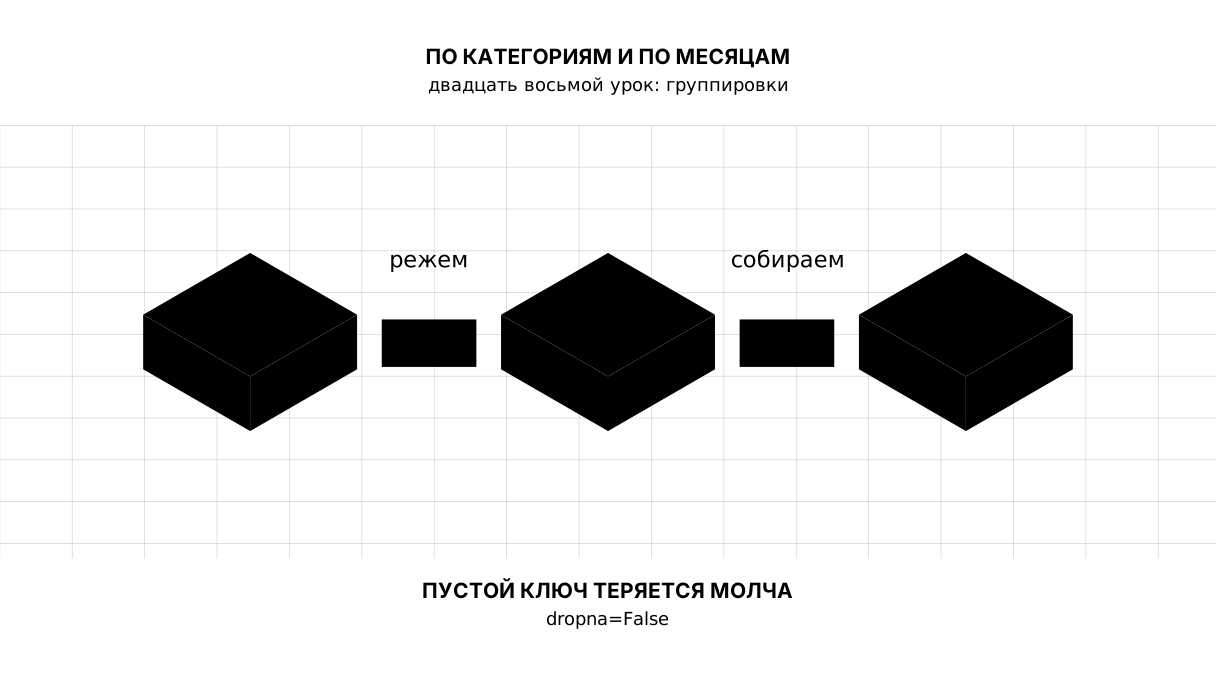
df.groupby("kind")["amount"].sum() делает три вещи: режет таблицу на куски по значению kind, считает сумму в каждом, складывает куски обратно в один ряд. Ключ становится подписью — тем самым индексом из двадцать пятого урока, — поэтому ответ можно сразу сортировать, фильтровать и складывать с другим таким же рядом.
Порядок групп по умолчанию — по возрастанию ключа, а не по величине ответа. Если нужен рейтинг, его просят отдельно: .sort_values(ascending=False).
Несколько чисел сразу и свои имена
agg(["count", "sum", "mean"]) даёт три столбца вместо одного. Имена у них — имена функций, и в отчёте они выглядят как черновик.
Именованная форма читается как определение отчёта:
df.groupby("kind").agg(
    чеков=("amount", "count"),
    всего=("amount", "sum"),
    средний=("amount", "mean"),
)
Слева — имя столбца в ответе, справа — пара «по какому столбцу считать» и «чем считать». В одном agg можно смешивать разные столбцы: дороже=("amount", "max"), первый_день=("day", "min").
count считает непустые значения, size — все строки
Разница не косметическая. count считает значения, которые есть, — любые: числа, строки, даты; пропуски он пропускает. size считает строки группы целиком. Расхождение между ними и есть число пропусков в том столбце, который вы посчитали. В примере после одного стёртого значения у «еды» count даёт 3, а size — 4.
Отсюда же и разница в обращении: count спрашивают у столбца (groupby(...)["amount"].count()), а size — у группы целиком, ей столбец не нужен.
Это первый из двух способов молча получить неверный ответ. Второй хуже.
Группы, которые теряются
groupby по умолчанию выбрасывает строки, где ключ пустой. Сумма по группам тогда не сходится с общей суммой, и ничто об этом не говорит:
df["amount"].sum()                        → 1000
df.groupby("kind")["amount"].sum().sum()  → 800
Лечится аргументом dropna=False: пропуск становится отдельной группой. Привычка, которая стоит того, чтобы её завести: после группировки сверять итог с итогом по всей таблице. Если они разошлись — вы уже знаете, где искать.
Два ключа и подписи в два этажа
groupby(["city", "kind"]) даёт MultiIndex: подпись строки состоит из пары. Это удобно смотреть и неудобно передавать дальше, поэтому чаще всего сразу пишут .reset_index() — и получают обычную плоскую таблицу с двумя столбцами-ключами.
Ключ, которого нет в таблице
Группировать можно не только по столбцу, но и по любому ряду той же длины. Отсюда «по месяцам»: df["day"].dt.to_period("M") превращает дату в месяц, и по нему же группируем — столбца «месяц» в таблице при этом может и не быть.
to_period("M") даёт не строку "2026-01", а период: он сортируется как время, а не как текст, и умеет складываться с числом месяцев. Для группировки по дням есть dt.date, по годам — dt.year, по дням недели — dt.day_name().
transform: ответ группы рядом с каждой строкой
agg сжимает группу в одно число. transform возвращает столько же значений, сколько было строк, — то же групповое число, размноженное по строкам своей группы. Отсюда доля:
df["amount"] / df.groupby("city")["amount"].transform("sum") * 100
У каждой строки в знаменателе стоит сумма её собственного города. Тем же приёмом считают отклонение от среднего по группе и место внутри группы (rank).
Карта урока
Скажите своими словами
Не подглядывая, ответьте вслух или на бумаге. Ответы — в конце урока.
- Что делает
groupbyи во что превращается ключ в ответе? - Чем
countотличается отsizeи что означает разница между ними? - Чем
transformотличается отaggи когда нужен именно он?
Разминка
Три коротких шага перед заданием: предсказать, дописать, починить. Ответы — в конце урока, но сначала ответьте сами.
1. Предскажите. Что напечатает эта программа?
import pandas as pd

df = pd.DataFrame({"kind": ["еда", "еда", "связь"], "amount": [1200, 800, 4990]})
print(df.groupby("kind")["amount"].sum().to_dict())
print(df.groupby("kind")["amount"].agg(["count", "max"]).to_string())
2. Заполните пропуск. Вместо ... назовите столбец «всего» и посчитайте в нём сумму.
# именованный агрегат: имя слева, пара «столбец, чем считать» справа
import pandas as pd

df = pd.DataFrame({"kind": ["еда", "еда", "связь"], "amount": [1200, 800, 4990]})
print(df.groupby("kind").agg(...).to_string())
3. Почините. Сумма по группам не сходится с общей суммой на двести. Ничего не пропало — просто одна группа не попала в ответ.
# 1000 против 800: где ещё двести
import pandas as pd

df = pd.DataFrame({"kind": ["еда", None, "еда", "связь"], "amount": [100, 200, 300, 400]})
print("всего:", int(df["amount"].sum()))
print("по группам:", int(df.groupby("kind")["amount"].sum().sum()))
Задание
Обязательное. Возьмите те же двенадцать чеков из урока и постройте отчёт по месяцам и категориям: число чеков, сумма и доля категории внутри своего месяца. Отчёт отсортируйте по месяцу, а внутри месяца — по сумме сверху вниз. В конце напечатайте итог по месяцам и месяц, где потратили больше.
Ожидаемый вывод:
  месяц    kind  чеков  всего  доля
2026-01  аренда      1  95000  65.7
2026-01 топливо      2  34700  24.0
2026-01     еда      3   9900   6.8
2026-01   связь      1   4990   3.5
2026-02  аренда      2 157000  85.4
2026-02 топливо      1  19100  10.4
2026-02   связь      1   4990   2.7
2026-02     еда      1   2800   1.5

итог по месяцам: {'2026-01': 144590, '2026-02': 183890}
месяц с наибольшими расходами: 2026-02
Готово, когда: вывод совпадает построчно; доля считается от суммы своего месяца, а не от суммы за оба; столбцы названы в agg, а не переименованы после; месяц получен из даты, а не вырезан из строки; месяц с наибольшими расходами найден через idxmax.
На своих данных. Сгруппируйте свою таблицу по любому полю и посчитайте три числа. Потом сверьте: сумма по группам равна сумме по всей таблице? Если нет — посмотрите, нет ли пропусков в ключе.
По желанию.
- Сгруппируйте по дню недели (
dt.day_name()) и посмотрите, в какой день расходы больше. - Добавьте в
aggстолбец из другого поля:первый_день=("day", "min"). - Посчитайте через
transform("mean")отклонение каждого чека от среднего по его категории.
Куда это встанет в проекте
Девятый шаг: сводка перестаёт смотреть на одну страну. Три приходят одним запросом — банк принимает коды через точку с запятой, — и таблица становится длинной: строка на страну и год.
Ради этой формы всё и затевалось: отчёт превращается в один вопрос вместо цикла по странам. groupby("country").agg(...) даёт годы, пропуски, среднее и максимум, а год максимума приходит из idxmax внутри группировки — подпись наибольшего значения это и есть та строка, а строка знает свой год.
Долги. Страны в отчёте называются кодами KAZ, UZB, RUS — так их отдаёт банк. Названия лежат в том же ответе, но чтобы поставить их рядом, нужна вторая таблица и соединение по ключу. Это следующий урок.
Ответы
Показать ответы
На вопросы
- Режет таблицу на куски по ключу, считает каждый кусок отдельно и собирает ответы обратно в таблицу. Ключ становится подписью строки — индексом, — поэтому ответ можно сортировать и складывать с другими рядами по тем же подписям.
countсчитает значения, которые есть, — числа, строки, даты, что угодно;sizeсчитает все строки группы. Их разница и есть число пропусков в том столбце, который вы посчитали.aggсжимает группу в одно число,transformвозвращает столько же значений, сколько строк, повторяя групповое число для каждой строки своей группы. Он нужен, когда групповой ответ должен встать рядом с исходными строками: доля, отклонение от среднего, место внутри группы.
К разминке
- Группировка по категории даёт сумму по каждой, а
aggсо списком — два столбца с именами функций.
{'еда': 2000, 'связь': 4990}
       count   max
kind
еда        2  1200
связь      1  4990
всего=("amount", "sum"). Имя столбца слева от знака равенства, пара «по чему считать, чем считать» — справа.
import pandas as pd

df = pd.DataFrame({"kind": ["еда", "еда", "связь"], "amount": [1200, 800, 4990]})
print(df.groupby("kind").agg(всего=("amount", "sum")).to_string())
       всего
kind
еда     2000
связь   4990
groupby("kind", dropna=False). Строка с пустым ключом по умолчанию не попадает ни в одну группу, и двести уходят молча.
import pandas as pd

df = pd.DataFrame({"kind": ["еда", None, "еда", "связь"], "amount": [100, 200, 300, 400]})
print("всего:", int(df["amount"].sum()))
print("по группам:", int(df.groupby("kind", dropna=False)["amount"].sum().sum()))
всего: 1000
по группам: 1000
К заданию
Доля считается через transform("sum") по месяцу: у каждой строки в знаменателе должна стоять сумма её собственного месяца, а не общая. Если поделить на report["всего"].sum(), доли сложатся в сто процентов по всему отчёту, а не по каждому месяцу — и это будет другой ответ на другой вопрос.
Сортировка — по двум ключам сразу: sort_values(["месяц", "всего"], ascending=[True, False]), потому что месяцы идут по порядку, а суммы внутри месяца — от большей к меньшей.
Источники
- Группировка: split-apply-combine — как это устроено и что ещё умеет.
- Именованные агрегаты — форма, в которой отчёт читается как отчёт.
- Работа с датой и временем —
dt, периоды и всё, по чему можно группировать время.
Если вы нашли ошибку или опечатку в тексте статьи, то сообщите нам об этом
Комментарии (0)
Войдите, чтобы оставить комментарий →
Пока нет комментариев. Будьте первым.