

Информатика: создаём своего цифрового помощника Урок 13 из 18
Как компьютер различает Ә, Я и A
Узнаем, как один файл сохраняет казахскую Ә, русскую Я и латинскую A, и почему символ не равен байту.
Текст переведён с помощью ИИ.
Где мы на карте
В прошлой части мы научились находить файлы и различать программу и данные. Теперь разберём, как данные могут передать смысл так, чтобы другой человек и другая программа прочитали их одинаково. Сначала назовите собственную догадку, затем проверьте её на числах. После проверки запишите, какую мысль пришлось изменить.
Жизненный образ и точная модель
Вы отправили другу название задачи «Әлем». Если он видит непонятные знаки, дело часто в несовпавшем способе прочитать байты. Это похоже на адрес: номер квартиры один, но запись адреса на бумаге может занимать разное место.
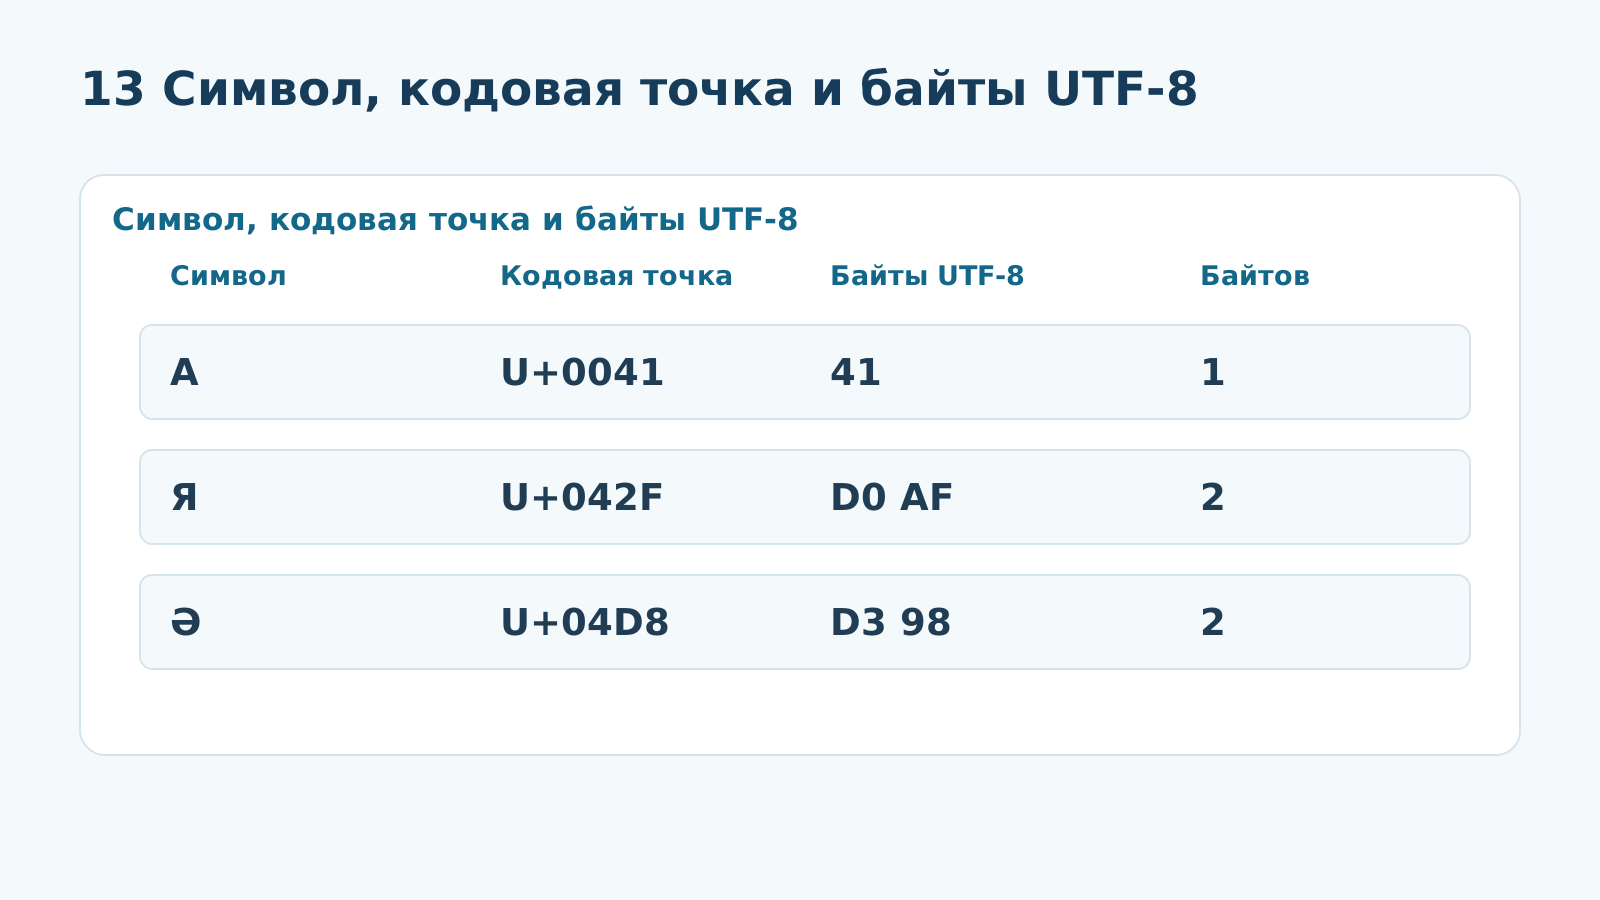
Unicode назначает символам кодовые точки: A — U+0041, Я — U+042F, Ә — U+04D8. UTF-8 превращает кодовые точки в байты: A → 41, Я → D0 AF, Ә → D3 98 (в шестнадцатеричной записи). Значит, A занимает один байт, а Я и Ә — по два в UTF-8. Количество видимых знаков, кодовых точек и байтов может различаться, особенно с составными знаками.
Граница образа
«Один символ — один байт» неверно. Кодовая точка Unicode не является готовой последовательностью байтов: для сохранения выбирают кодировку. Даже понятие видимого символа может включать несколько кодовых точек, например букву с отдельным знаком ударения.
Опорный сигнал
видимый знак → кодовая точка Unicode → кодировка UTF-8 → байты
Разобранный пример
Запишите три пары: A / U+0041 / 41; Я / U+042F / D0 AF; Ә / U+04D8 / D3 98. Первое число после U+ — кодовая точка, последнее — байты UTF-8. Прочитайте обратным ходом: D3 98 при UTF-8 означает Ә.
Предскажите до наблюдения
Сколько байтов UTF-8 нужно для текста «AӘ»? Сначала подсчитайте символы: два. Затем сложите 1 + 2 = 3 байта. Не добавляйте сюда размер имени файла или заголовка.
Не прокручивайте сразу к ответу: запишите прогноз и причину. Сравните не только итог, но и каждый промежуточный шаг. Если результат совпал случайно, повторите опыт с другими числами.
Воспроизведите без подсказки
Без таблицы объясните, почему «Я» не обязана занимать столько же байтов, сколько «A». Затем вернитесь к таблице и проверьте два конкретных значения.
Закройте разобранный пример листом бумаги. Восстановите цепочку по короткому сигналу, проговорите смысл каждого перехода и лишь затем откройте пример для самопроверки. Если застряли, посмотрите только предыдущий шаг.
Найдите и исправьте ошибку
«U+04D8 — это байты D4 D8». Исправьте смешение кодовой точки и кодировки: в UTF-8 для Ә записываются D3 98. Кодировку надо назвать явно.
Перенос в новую ситуацию
Друг сохранил казахский текст в UTF-8, а другая программа читает его как иную кодировку. Предскажите результат и предложите проверку: убедиться в кодировке при записи и чтении, затем сравнить исходный текст после повторного открытия.
Изменение проекта
Создайте пробный файл с названием задачи «Әлем» и строкой «Я и A». Укажите в FORMAT.md, что файлы проекта сохраняются в UTF-8. Закройте и откройте файл вновь; проверьте все три буквы. Не используйте реальные личные данные.
Задание
Составьте маленькую таблицу для A, Я, Ә: кодовая точка, байты UTF-8 и число байтов. Объясните, почему число знаков не позволяет точно узнать размер текста.
Сдавайте не фразу «понял», а проверяемое доказательство: таблицу, расчёт, файл или точный ответ с объяснением. Используйте вымышленные данные. Попросите другого человека повторить действие по вашему описанию; если ему приходится угадывать, уточните правило.
Возврат через 1, 7 и 30 дней
Завтра восстановите путь от знака до байтов. Через неделю объясните разницу между U+04D8 и D3 98. Через месяц проверьте перенос файла между двумя программами.
Если вы нашли ошибку или опечатку в тексте статьи, то сообщите нам об этом
Комментарии (0)
Войдите, чтобы оставить комментарий →
Пока нет комментариев. Будьте первым.